1つのコマンド:
python generate.py --task t2v-A14B --size 1280*720 \
  --ckpt_dir ./Wan2.2-T2V-A14B --prompt "Two anthropomorphic cats boxing"
数分後、81フレーム、720p、16fps の動画が得られる。この記事では、その途中で起きる各ステップを徹底的に説明する。すべてのコードは Wan2.2 リポジトリの原文から取り、すべての数字は設定ファイルから計算できる。計算式もあわせて書いておく。読み終えれば、次の問いに答えられるはずだ:
- なぜフレーム数は必ず 4n+1 でなければならず、80フレームではだめなのか?
- 14B というパラメータ数は設定からどう数えられるのか?80GB の VRAM 要件はどう計算するのか?
- flow matching と DDPM は数学的にどこが違い、なぜ前者は 40ステップで動画を生成できるのか?
--sample_shift 12は何のつまみを回しているのか?それは MoE エキスパート切り替えと、見えないところでどう連動しているのか?- 画像から動画を生成する場合、テキストから動画を生成する骨格のうち、具体的にどの数行が変わったのか?
全文は「原理 → データ → ネットワーク → サンプリング → エンジニアリング」の順に展開する。各章では、それ以前の章で説明した概念だけを使うので、順番に読むことを勧める。テンソルと attention が何かは大まかに知っている前提だ。完全にゼロからなら、まず 10分かけてこの 2つの言葉を調べてから戻ってきてほしい。その 10分には価値がある。
3つのモデル、1つの舞台
動画生成は 1つのモデルが担っているのではない。3つある。
| モデル | 役割 | Wan2.2 t2v-A14B では |
|---|---|---|
| テキストエンコーダ | prompt をベクトル列に変換する | umT5-XXL の encoder、約 5.7B パラメータ |
| 拡散バックボーン | ノイズから動画の圧縮表現を一歩ずつ「彫り出す」 | WanModel、DiT アーキテクチャ、40層、14B パラメータ × 2エキスパート |
| VAE | ピクセルと圧縮表現のあいだを相互に翻訳する | Wan2_1_VAE、時空間圧縮率 4×8×8 |
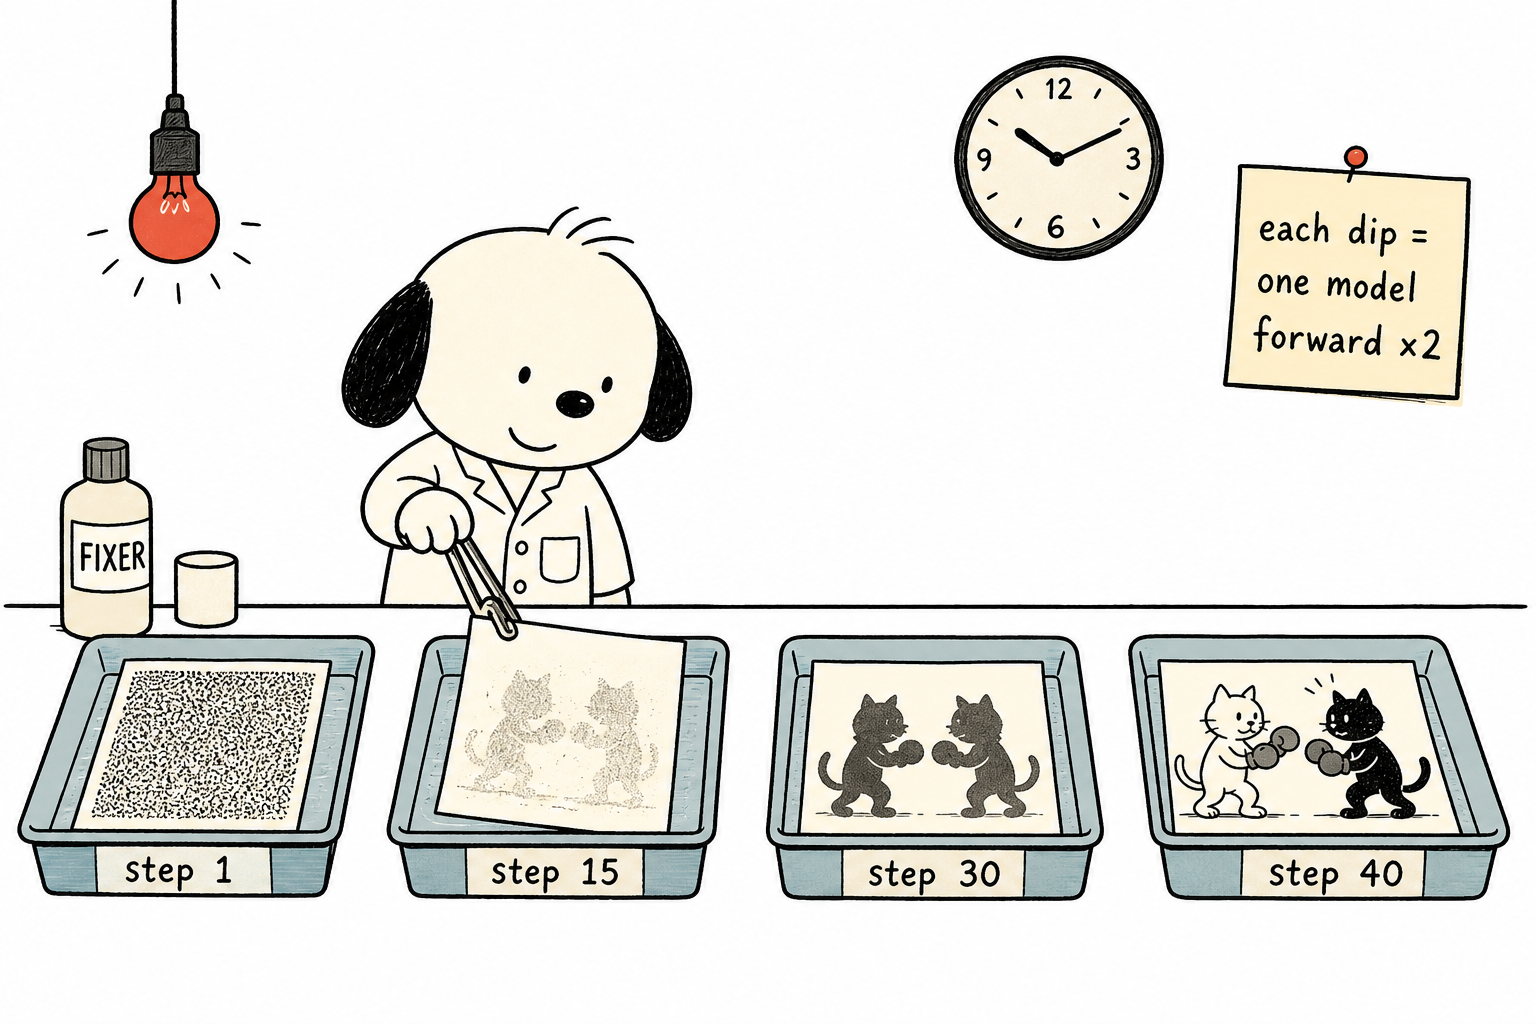
「拡散」という言葉については、まず 3文で下敷きを置いておき、第1章で詳しく展開する。モデルが学ぶのは「ノイズの塊からきれいなデータへ修正していく」方向である。推論時には完全なランダムノイズから出発し、モデルに 40回方向を尋ね、40回動かすことで、ノイズが少しずつ動画として現像されていく。あなたの prompt は、その毎回の方向判断に関与する。この骨格を覚えておけば、後ろに出てくる各部品をそこへ掛けて理解できる。
分業は明確だ。T5 は冒頭で 1回だけ走る。VAE の encoder は t2v ではそもそも使われない(入力画像がないため)。decoder は最後に 1回だけ走る。本当に計算資源を燃やすのは中央の拡散バックボーンで、これは 40ステップ走り、各ステップで 2回 forward する(なぜ 2回なのかは第5章で展開する)。
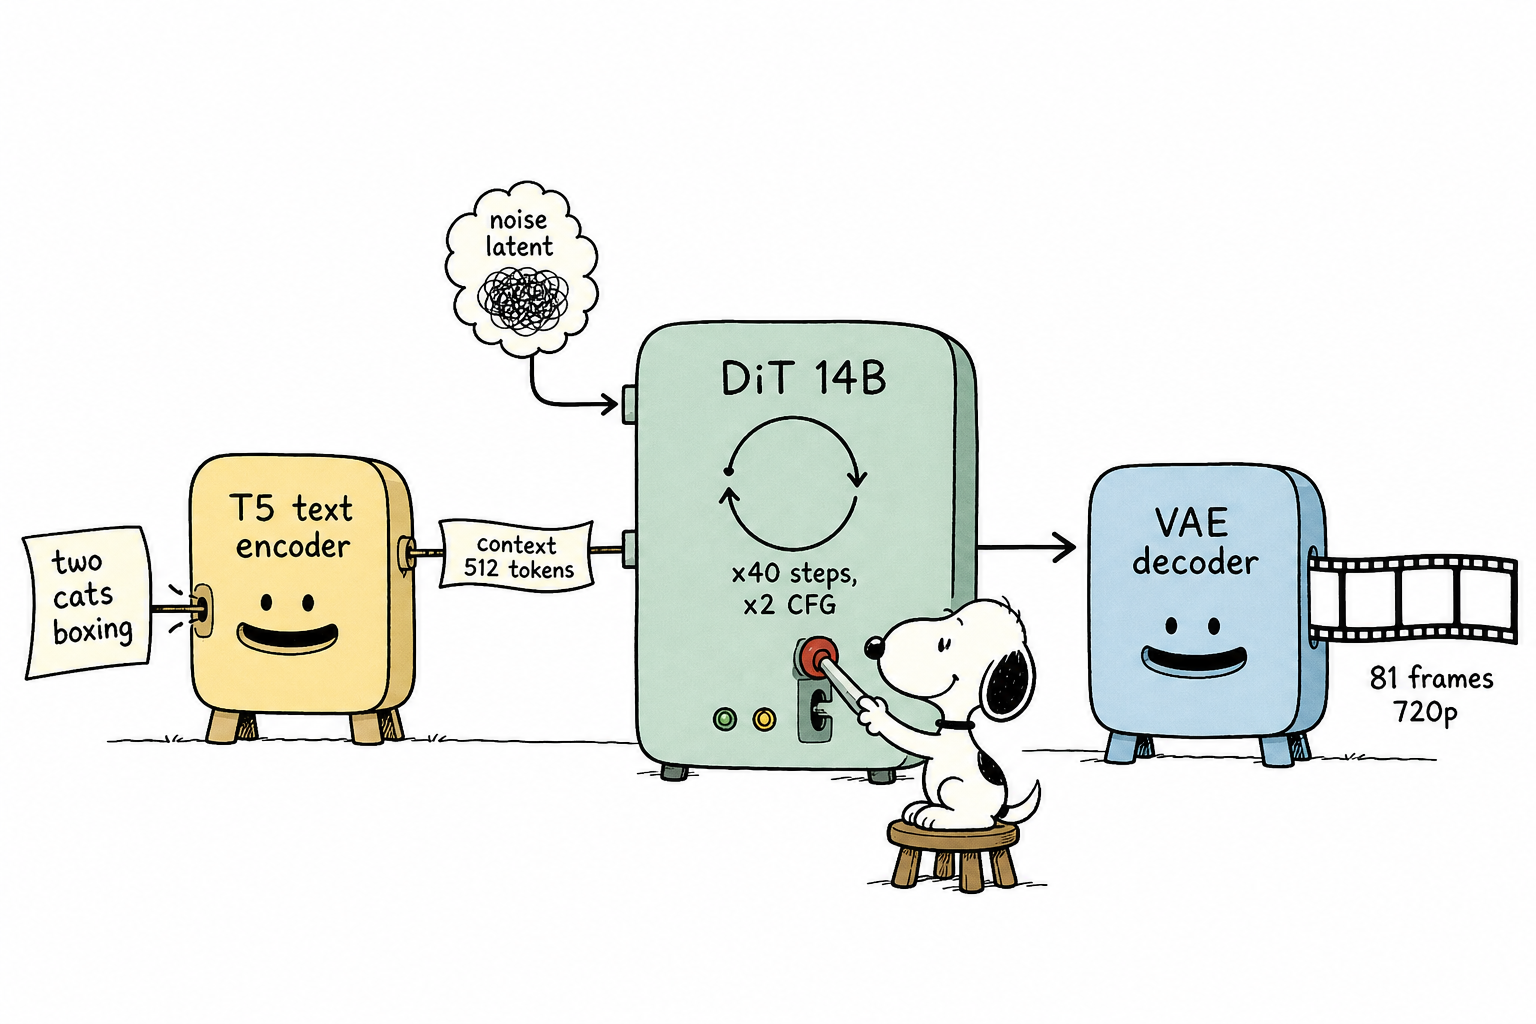
3つのモデルがどう直列につながるかは、wan/text2video.py の generate() がその台本になっている。テキストをエンコードする → ノイズをサンプリングする → ループで denoise する → ピクセルへデコードする。この台本については、まず骨格を覚えておく価値がある。以降の各章は、その中のどれか 1行を展開していく。
先に前提となる問題を片づけよう。なぜ拡散をピクセル上で直接やらないのか? 計算してみる。81フレームの 720p RGB 動画には、
81 × 720 × 1280 × 3 ≈ 2.24億個の数値
がある。
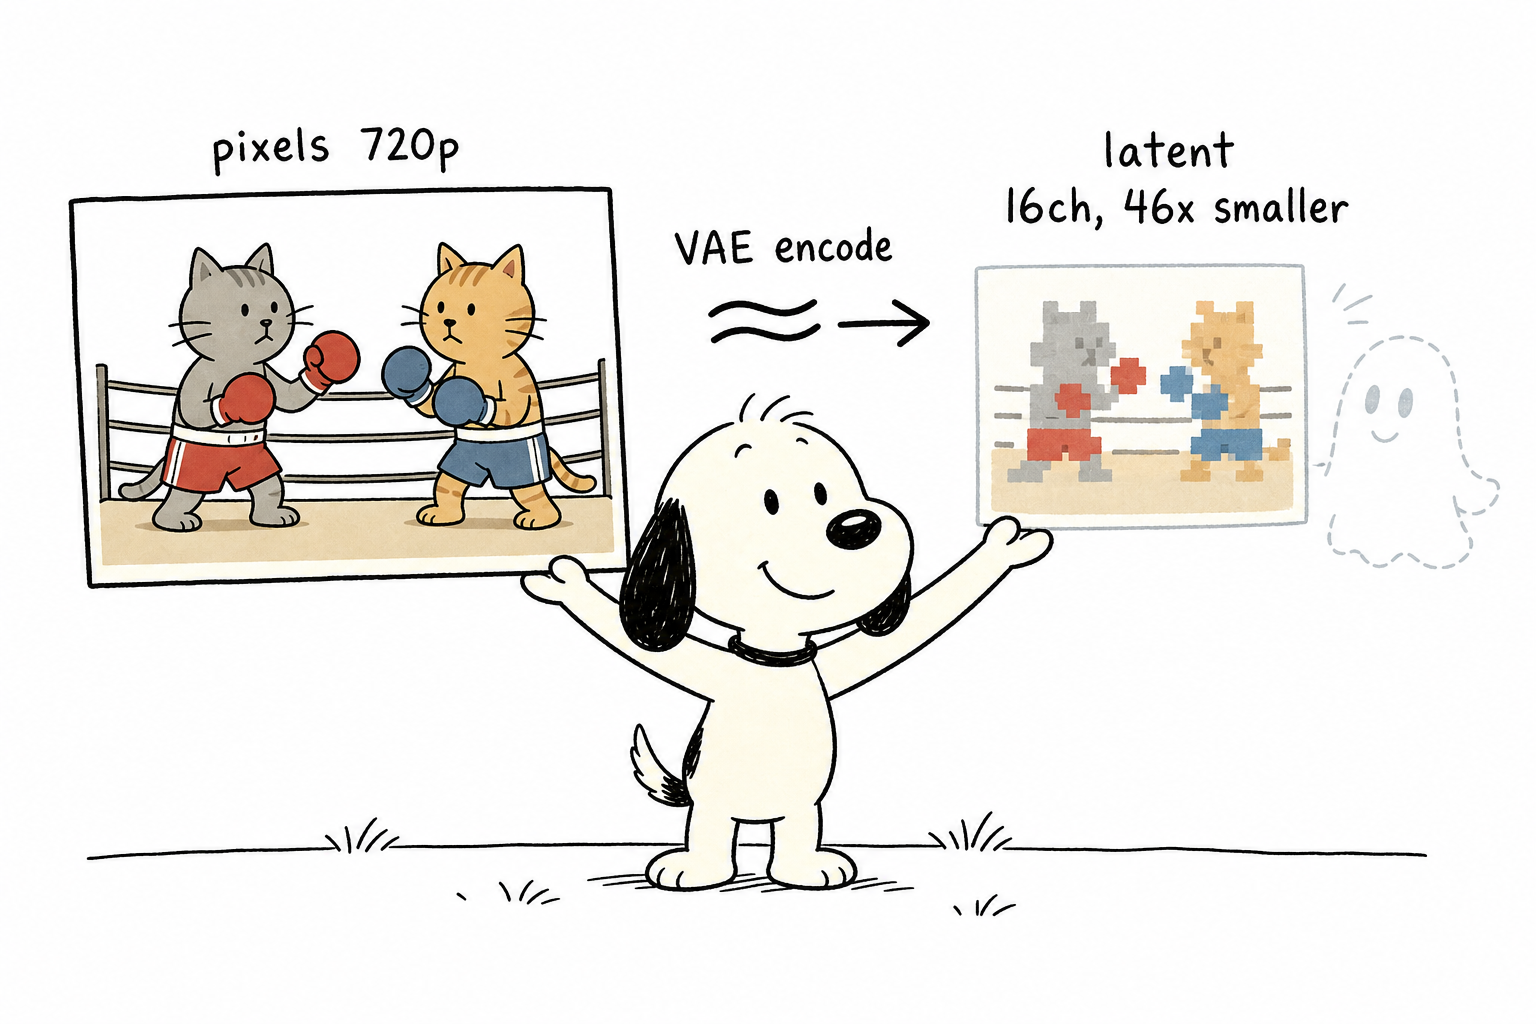
VAE で圧縮すると、latent は
16 × 21 × 90 × 160 ≈ 484万個の数値
しかない。
46倍少ない。拡散バックボーンはこのデータに対して forward を 80回も繰り返すので、データが 46倍小さくなれば、attention と畳み込みのコストもまとめて崩れ落ちる。圧縮空間で生成し、最後の 1ステップだけピクセルへ戻す。この考え方を latent diffusion と呼ぶ。Stable Diffusion 以降の標準手法になり、動画生成ではそれを 2D から 3D へ拡張している。
第1章:ノイズ除去は直線を進む
まずコードはいっさい見ずに、いちばん根本的な問題を片づける。なぜ「ノイズの中から一歩ずつ直す」だけで、新しい動画を何もないところから生成できるのか?
なぜ「ノイズを足してからノイズを取る」と生成できるのか
生成モデルが解きたい問題は、「自然な動画の分布」から新しいサンプルを1つサンプリングすることだ。この分布には解析的な形がなく、直接サンプリングしようとしても手がかりがない。拡散系の方法の考え方は、道を1本作ることだ。片方の端は自然データ、もう片方の端は標準ガウスノイズ(こちらはいくらでもサンプリングできる)。そしてネットワークに、その道をノイズ側からデータ側へ戻る歩き方を学習させる。ノイズを加える過程は道作りであり、複雑な分布と単純な分布をつなぐ。ノイズ除去ネットワークは、その道の各位置で「データ方向へどう進むべきか」を学ぶ。訓練時、ネットワークは膨大な「位置 → 方向」のサンプルを見る。推論時にはランダムノイズから出発し、学習した方向場に沿って進む。終点は訓練データらしく見えるが、どの訓練データそのものでもない新しいサンプルになる。prompt は各ステップの方向判断に参加し(具体的な仕組みは第3章、第4章)、終点を「この記述に合う」領域へ制約する。
DDPM から flow matching へ
古典的な DDPM は、この道をこう定義する。前向き過程では、精密に設計された分散スケジュールに従ってガウスノイズを段階的に加える。逆向き過程では、各ステップで加えられたノイズを予測するようネットワークを訓練し、サンプリング時にはベイズの式に従って一歩ずつ剥がしていく。これはちゃんと work する。ただし経路はランダムウォークでできた曲線で、サンプリングには数百ステップが必要になり、分散スケジュール表そのものも調整が必要なハイパーパラメータになる。
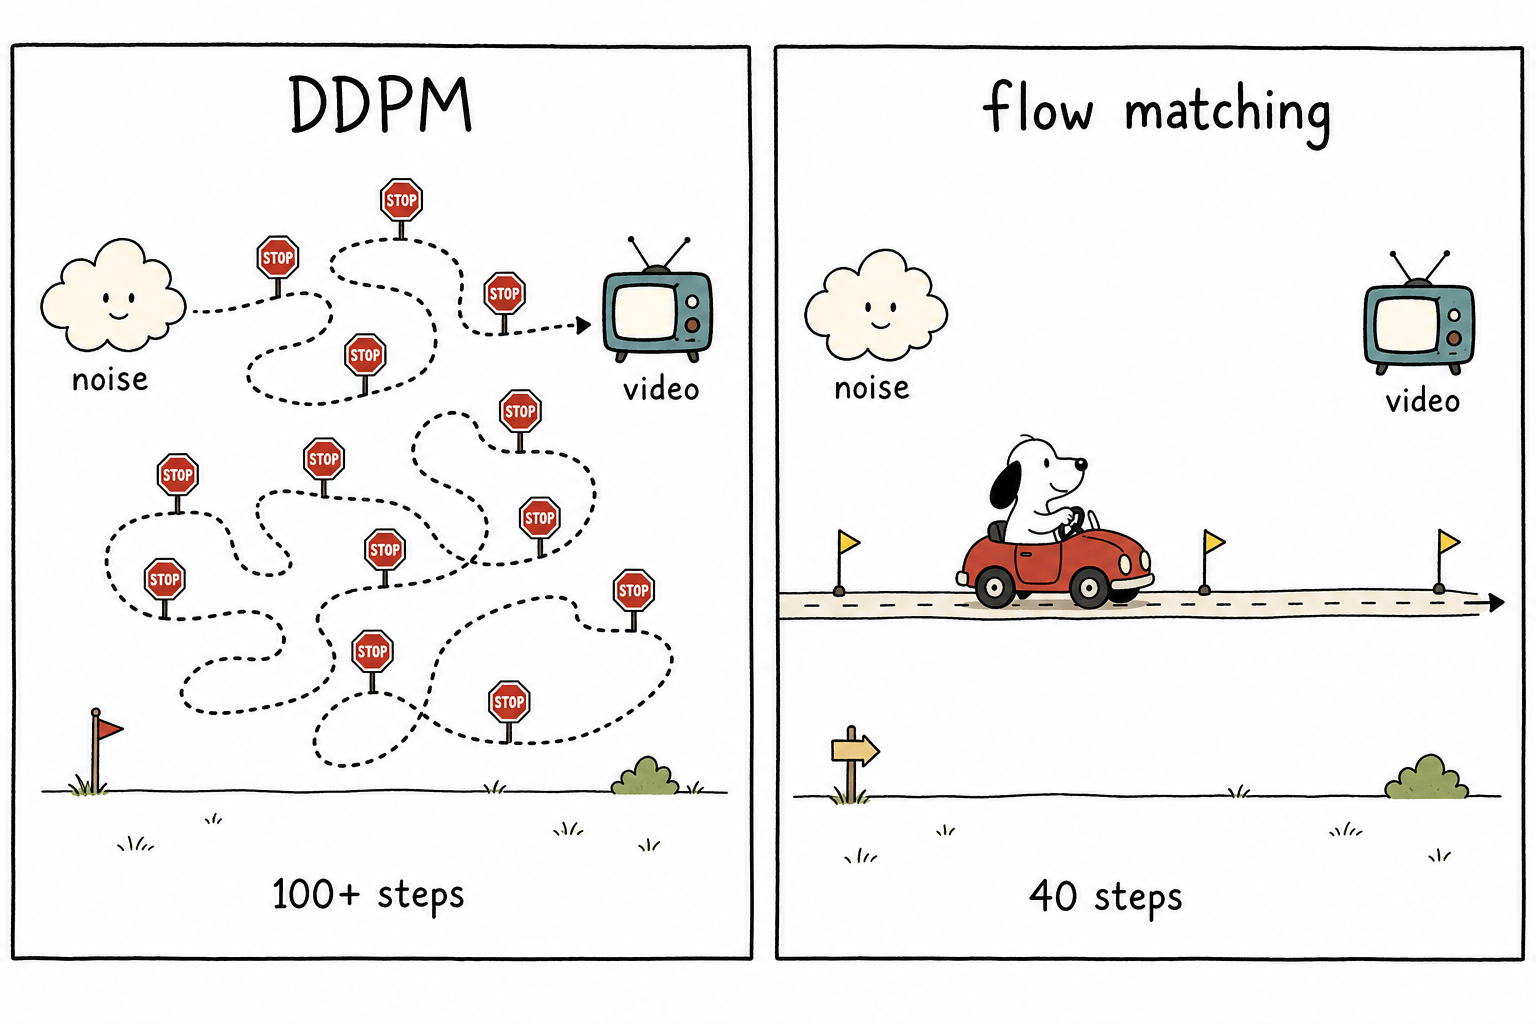
flow matching(Wan2.2 が使うのは、その中で最も単純な rectified flow)は、問題をもっと素直に変える。クリーンなデータ x₀ と純粋なノイズ x₁ の間を、直線補間で直接中間状態として定義する。
x_t = (1 - t)·x₀ + t·x₁ , t ∈ [0, 1]
この直線に沿うと、任意の時刻での「速度」は定数になる。
dx_t/dt = x₁ - x₀
したがって訓練目標は、4行の擬似コードで書けるほど単純になる。
x0 = 実動画の latent を1つサンプリング
x1 = 標準ガウスノイズを1つサンプリング
t  = [0, 1] の時刻を一様にサンプリング
loss = || model((1-t)·x0 + t·x1, t, text) - (x1 - x0) ||²
分散スケジュール表もない。ELBO の導出もない。ベクトル場を回帰するだけだ。リポジトリには推論コードしかないが、訓練ループはだいたいこの形になる。モデルの能力はすべて、億単位の動画クリップ上でこの4行を繰り返すことから来ている。
推論時は逆向きに進む。純粋なノイズ x₁ から出発し、ネットワークが予測した速度に沿って数値積分し、x₀ へ戻していく。理想的には軌跡は直線なので、1ステップで到達できる。だが実際にはネットワークの速度場は完全ではなく、1歩進んだあとの位置に対応する真の速度はすでに変わっている。だからやはり分割して進み、1歩ごとに道を尋ねる必要がある。ただし直線という事前のおかげで、DDPM のランダムウォークより回り道ははるかに少ない。DDPM は GPS のない街で通行人に道を聞きながら運転するようなもので、交差点ごとに止まる必要がある。flow matching が作る道はそもそも直線なので、少し進むごとに方向を確認すれば十分だ。40ステップで画像が出る。同じ品質なら、DDPM の時代には数百ステップが必要なことが多かった。
コード上でも、この数学はそのまま見える。スケジューラファイル fm_solvers_unipc.py(第5章の主役)の核心はこの1行だ。
if self.config.prediction_type == "flow_prediction":
    sigma_t = self.sigmas[self.step_index]
    x0_pred = sample - sigma_t * model_output
導出は短い。補間式の t を σ と書き、x_t = (1-σ)x₀ + σx₁、モデル出力を v = x₁ - x₀ とすると、
x_t - σ·v = (1-σ)x₀ + σx₁ - σx₁ + σx₀ = x₀
現在のサンプルから σ 倍の速度予測を引くと、ちょうどクリーンデータの推定になる。コード1行、代数1行。
1本の物差し、2種類の目盛り
以降では σ、t、1000、40 という数が同時に出てくるので、先に関係を固定しておく。導出上の σ ∈ [0, 1]。コード内の時間ステップ t は、それに 1000 を掛けた目盛りだ(設定は num_train_timesteps=1000)。t=875 は σ=0.875 という意味で、同じ物差しの2種類の目盛りにすぎない。t が大きいほどノイズに近く、小さいほど完成映像に近い。訓練時、モデルは 1000 個すべての目盛り上でサンプルを見ている。推論では、その物差しから 40 個の点を選んで立ち止まるだけで、各点ではモデルがいつもどおり働く。だからステップ数はサンプリング時の自由パラメータであり、--sample_steps を 50 ステップや 20 ステップに変えても合法だ。ただし積分精度が変わるだけで、モデルを変更する必要はない。これが「少ステップ蒸留」系の研究の入口でもある。モデルが各目盛りで歩けるなら、1歩でより遠くまで進めるよう訓練し、40ステップを4ステップまで圧縮できないか、という話だ。
第2章 VAE:動画はまず46倍小さくされる
原理がわかったところで、データに戻ろう。第1章の x₀ はピクセルではなく latent だ。この章では、ピクセルと latent がどう相互変換されるかを扱う。この変換が、チェーン全体に流れるすべてのテンソル形状を決めている。
wan/configs/wan_t2v_A14B.py には2行の設定がある。
t2v_A14B.vae_stride = (4, 8, 8)    # 時間×4, 高さ×8, 幅×8
t2v_A14B.patch_size = (1, 2, 2)    # DiT の patch サイズ
時間次元は4倍圧縮、空間は各次元で8倍圧縮される。text2video.py はこれを使って latent の形状を計算する。
target_shape = (self.vae.model.z_dim, (F - 1) // self.vae_stride[0] + 1,
                size[1] // self.vae_stride[1],
                size[0] // self.vae_stride[2])
F=81、720×1280 を代入すると、(16, 21, 90, 160) になる。16個の latent チャンネル、21枚の「latent フレーム」、90×160 の空間グリッドだ。16個のチャンネルには赤・緑・青のような意味はない。ネットワークが自分で学習した「内部メモ」のようなもので、人間には読めないが、それで十分というわけだ。
4n+1 の由来
時間次元の式が F // 4 ではなく、(F - 1) // 4 + 1 になっている点に注意しよう。動画の1フレーム目は単独で1つの latent フレームにエンコードされ、その後は4フレームごとに1つへ圧縮される。81フレーム = 1 + 80 で、80 はちょうど4で割り切れるため、1 + 20 = 21 個の latent フレームになる。80フレームや82フレームを渡すと、この割り算が割り切れず、テンソル形状が合わなくなってそのまま落ちる。frame_num は必ず 4n+1 でなければならない。この制約の源はまさにこの1行だ。CLI 引数にある妙なデフォルトフレーム数、たとえば 81、121、77 は、どれも適当に決めたものではない。全部 4n+1 である。
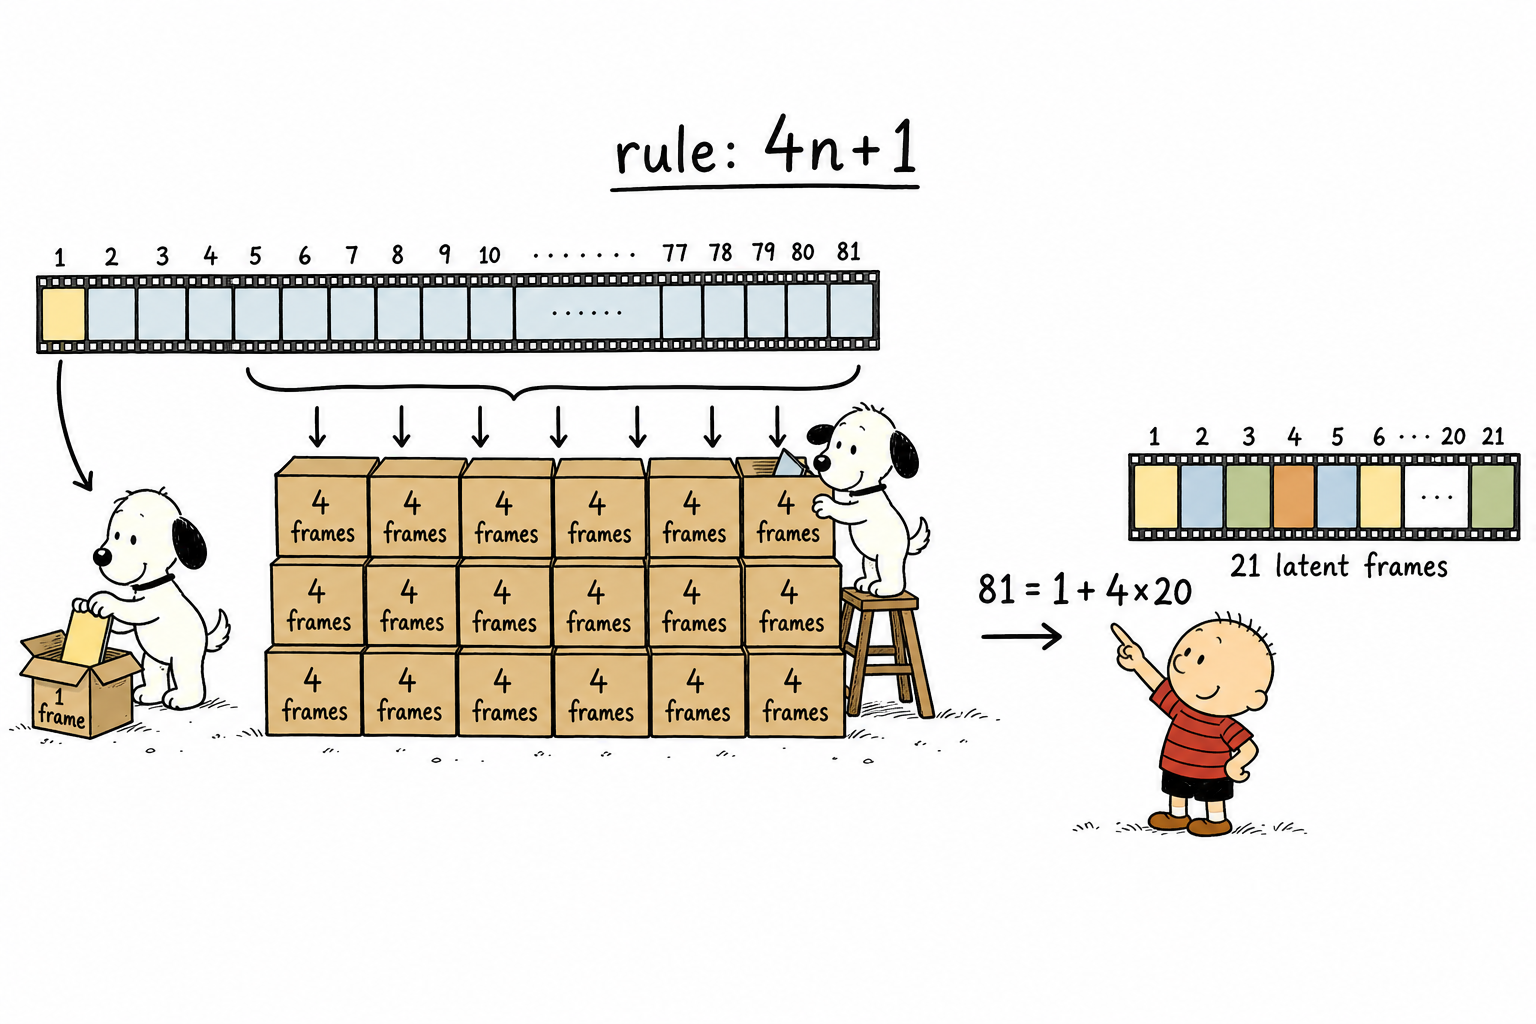
なぜ1フレーム目だけ特別扱いするのか。圧縮に使っているのが因果畳み込みだからだ。1フレーム目の前には参照できる履歴がないので、独立したフレームにするしかない。この設計には副産物もある。1枚の静止画は F=1 の動画と見なせるため、ちょうど1つの latent フレームを占める。画像と動画が同じ VAE の中で統一された表現を持つわけだ。第7章で画像から動画を生成する話をするとき、この点が効いてくる。
因果畳み込みとストリーミング推論
vae2_1.py にある CausalConv3d の実装を見ると、全部で十数行しかない。
class CausalConv3d(nn.Conv3d):

    def __init__(self, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self._padding = (self.padding[2], self.padding[2], self.padding[1],
                         self.padding[1], 2 * self.padding[0], 0)
        self.padding = (0, 0, 0)

    def forward(self, x, cache_x=None):
        padding = list(self._padding)
        if cache_x is not None and self._padding[4] > 0:
            cache_x = cache_x.to(x.device)
            x = torch.cat([cache_x, x], dim=2)
            padding[4] -= cache_x.shape[2]
        x = F.pad(x, padding)
        return super().forward(x)
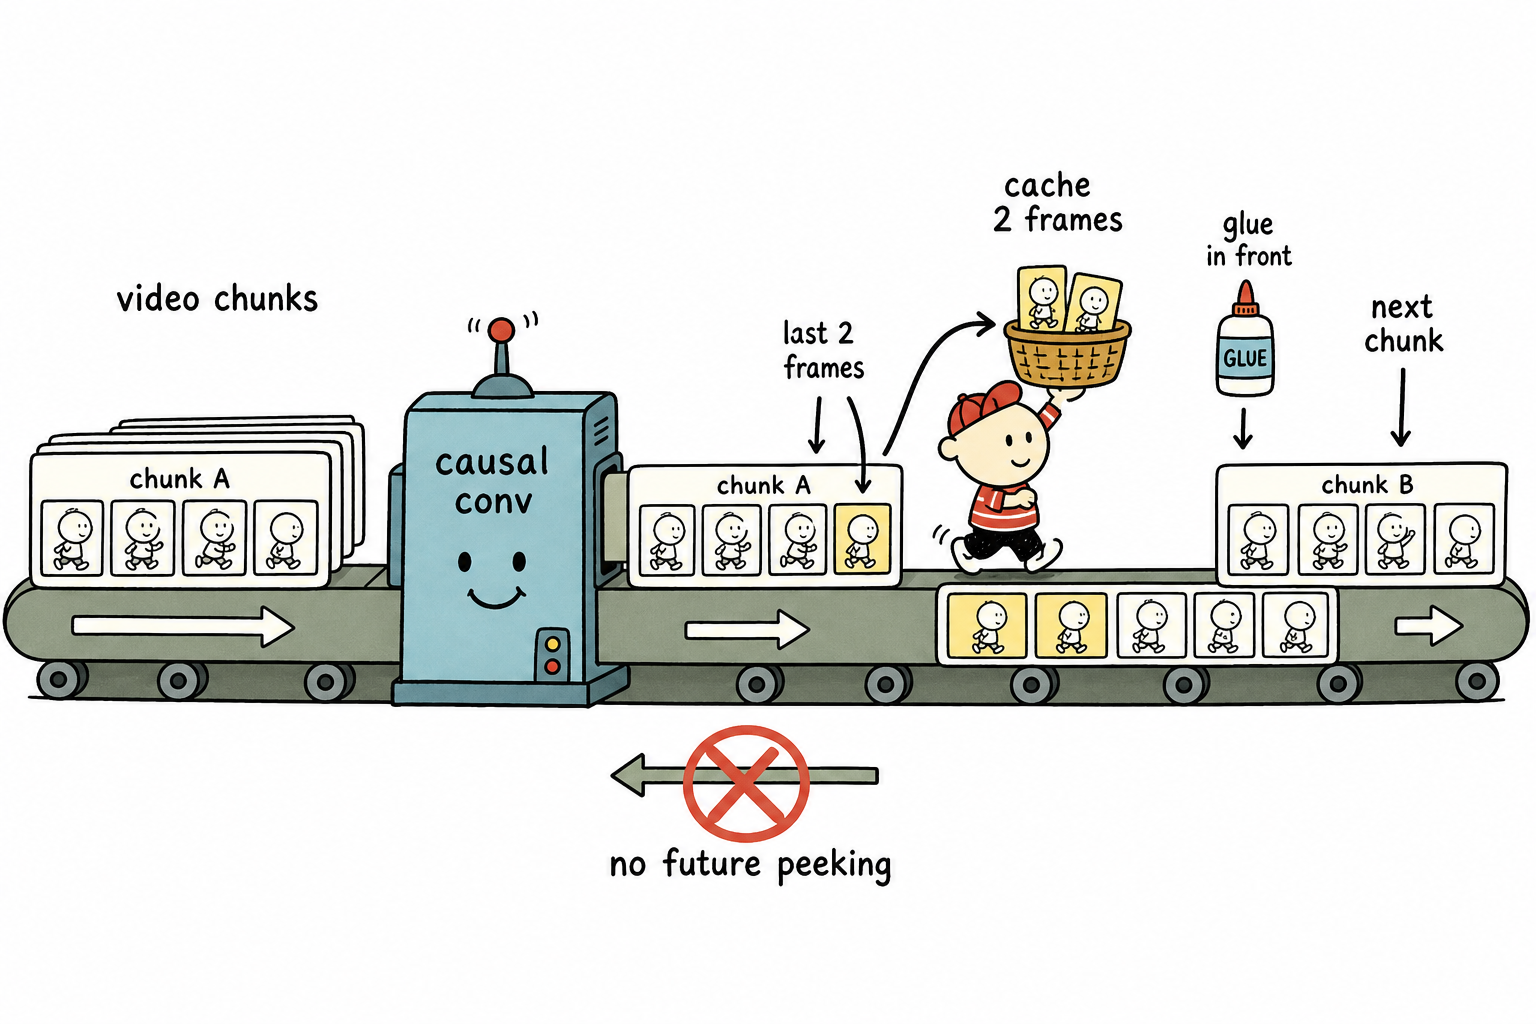
通常の 3D 畳み込みは、時間次元の前後に対称にゼロパディングするので、各フレームの出力は「未来フレーム」を見てしまう。ここでは時間次元の padding をすべて前側に寄せ、各フレームの出力が現在と過去だけに依存するようにしている。このコードを読むには、PyTorch のちょっとした豆知識が必要だ。F.pad の引数は最後の次元から数える。最初の4つの数は幅と高さ用で、末尾のペア (2 * self.padding[0], 0) が時間次元に対応する。前に2倍、後ろにゼロを詰める、という意味だ。
因果性の見返りとして、ストリーミング処理ができる。動画を小さなチャンクに分けて順にネットワークへ通し、各チャンクの処理後に最後の2フレーム、ソースファイル冒頭の CACHE_T = 2 をキャッシュして、次のチャンクの cache_x として前に連結する。数学的には動画全体を一度に畳み込むのと等価になる。つまり VAE の VRAM 使用量は動画全体の長さから切り離される。5秒の動画でも50秒の動画でも、VAE 部分のピーク VRAM は同じだ。forward 内の padding[4] -= cache_x.shape[2] は帳尻合わせをしている。キャッシュが肩代わりしたゼロパディングのぶんだけ、padding を減らしているのだ。
ネットワーク本体は標準的な階層型の畳み込みオートエンコーダで、Stable Diffusion の VAE と同系統だ。3回の空間ダウンサンプリングが8倍の空間圧縮に対応し、後半2段で時間軸をそれぞれ半分にして合計4倍にする。decoder は同じ階段を逆向きに登って戻る。拡散の主幹に比べると、ほとんど計算書に載らないほど小さい。14B に対して数億パラメータ級だ。それでも生成品質の上限を決めているのはこれだ。VAE が再構成できない細部は、拡散モデルがどれだけ上手く彫り込んでもピクセルには届かない。再構成品質、圧縮率、デコード速度は三すくみであり、各社の動画モデルが水面下で競っている部分でもある。
latent 空間の「為替レート」
VAE と拡散モデルは別々に訓練された2つのシステムであり、接続はハードコードされた統計量の組に頼っている。vae2_1.py にはこうある。
mean = [-0.7571, -0.7089, -0.9113, ..., -0.2921]   # 16 チャンネルそれぞれの平均
std  = [ 2.8184,  1.4541,  2.3275, ...,  1.9160]   # 16 チャンネルそれぞれの標準偏差
self.scale = [self.mean, 1.0 / self.std]
この32個の数値は訓練セット上で統計を取ったものだ。VAE encode の生の出力は、チャンネルごとにスケールが大きく異なる。std は最小 1.13、最大 3.27 で、3倍近い差がある。一方、拡散モデルは自分が相手にしているデータが標準正規分布に近いと仮定している。そのため latent を拡散モデルへ入れる前にチャンネルごとに標準化し、デコード前にまた元へ掛け戻す必要がある。この数字の組は、この VAE と拡散モデルのペアにおける「為替レート」だ。VAE を別版に変えたら、すべて無効になる。リポジトリには、ちょうど ti2v-5B 専用の VAE も別に入っている。圧縮比は 4×16×16、チャンネル数は48。モデルを半分小さくするだけでは足りず、データも一緒に小さくしなければならない。これが 5B を 24GB の民生 GPU で 121 フレーム動かせる鍵だ。2つの VAE の checkpoint は互換性がない。その根本原因は、この為替レートにある。VAE は単独で訓練されたあと凍結され、Wan2.1 のこの版の VAE は Wan2.2 の4つのタスクでそのまま使い回されている。
第三章 prompt はどこへ行ったのか
ノイズ除去の各ステップは prompt の指示を聞かなければならない。prompt はまず、モデルが計算できるものに変わる必要がある。
Wan2.2 は umT5-XXL(Google の多言語 T5 変種)の encoder でテキストをエンコードする。約 5.7B パラメータ、bf16 で保存すると約 11.4GB——この2つの数字は覚えておこう。第六章で VRAM 勘定に使う。エンコードの呼び出し経路はとても短く、t5.py の T5EncoderModel.__call__ を見れば一目瞭然だ。
def __call__(self, texts, device):
    ids, mask = self.tokenizer(
        texts, return_mask=True, add_special_tokens=True)
    ids = ids.to(device)
    mask = mask.to(device)
    seq_lens = mask.gt(0).sum(dim=1).long()
    context = self.model(ids, mask)
    return [u[:v] for u, v in zip(context, seq_lens)]
トークン化し、エンコードし、attention mask の実際の長さに従って1件ずつ padding を切り落とす。prompt は最大 512 個の 4096 次元ベクトル列になり、これが context だ。DiT の中での使われ方は1つだけ。各層の cross-attention が、動画 token を query に、context を key/value にする。テキストが直接ピクセルを描くわけではない。各ノイズ除去ステップで、モデルに意味方向を与え続ける——prompt は着工前に下される命令ではなく、工事中ずっと壁に掛かっている施工図なのだ。
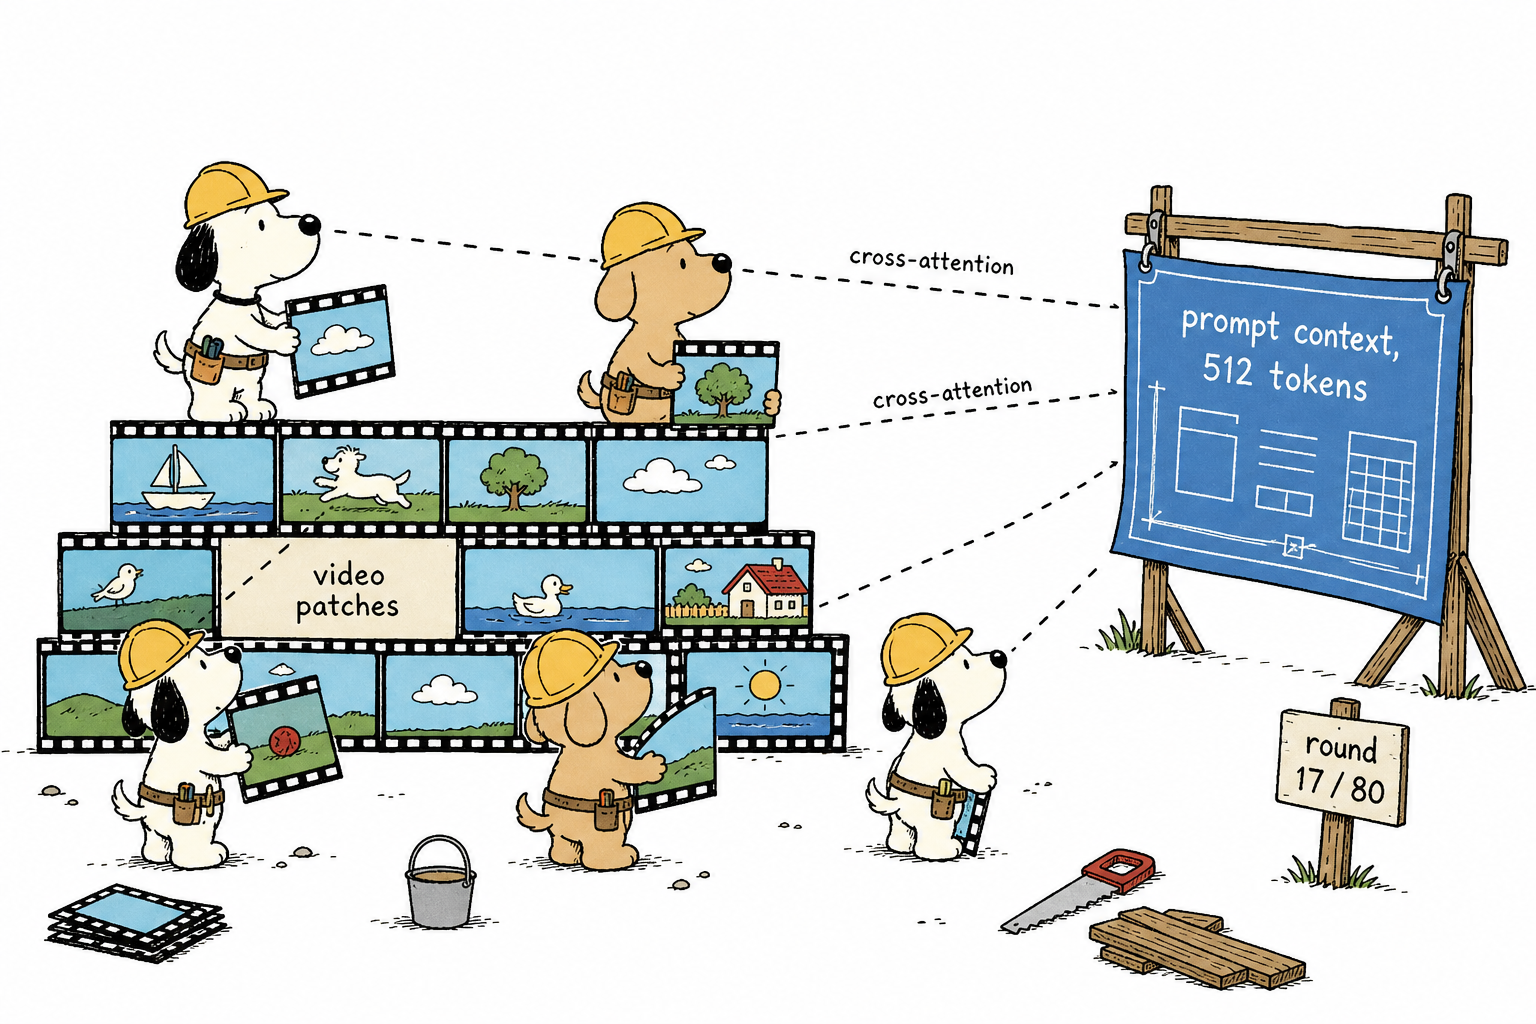
なぜ初期の text-to-image でよく使われた CLIP のテキスト塔ではなく T5 を使うのか。CLIP のベクトルは「この文がだいたい何を言っているか」を捉えるのは得意だが、77 token という上限では細かなシーン記述を詰め込めず、数量詞や空間関係にも弱い。T5 はテキスト自身の構造に沿って token ごとにエンコードし、上限は 512。token ごとの cross-attention と組み合わせることで、モデルは「左側の猫が赤いボクシンググローブをつけている」といった細部を区別できる。多言語版 umT5 を選ぶ理由ももう1つある。中国語 prompt が一等市民であり、公式の negative prompt はいっそ中国語で書かれている。
言っているのはこの negative prompt のことだ。設定内のデフォルト値は原文では次のとおり。
wan_shared_cfg.sample_neg_prompt = '色调艳丽,过曝,静态,细节模糊不清,字幕,风格,作品,画作,画面,静止,整体发灰,最差质量,低质量,JPEG压缩残留,丑陋的,残缺的,多余的手指,画得不好的手部,画得不好的脸部,畸形的,毁容的,形态畸形的肢体,手指融合,静止不动的画面,杂乱的背景,三条腿,背景人很多,倒着走'
これは「よくある失敗現場」のリストだ。その用途は第五章の CFG であらためて説明する。ここではまず、negative prompt も T5 を一度通り、context_null を得る、と覚えておけばいい。
最後の前処理がもう1つある。ユーザーが何気なく書く prompt はたいてい一文だけだが、モデルは長く細かな記述で訓練されている。短すぎる prompt を与えると、生成品質は落ちる。--use_prompt_extend は先に LLM(DashScope のオンライン API またはローカルの Qwen2.5)であなたの prompt を、カメラワーク、光、動作の詳細を含む長い記述へ拡張し、それから T5 に送る。マルチ GPU の場合、拡張は rank 0 で一度だけ実行してから他の GPU に broadcast する——LLM 生成にはランダム性があるため、8枚の GPU がそれぞれ拡張すると 8つの異なる prompt ができてしまい、動画をつなげられなくなる。
第四章 DiT: 75600 token の attention
部品はそろった。データは latent 空間にあり(第二章)、文字は context になり(第三章)、学ぶべき目標は速度場だ(第一章)。では、その速度を予測する機械を見よう。14B パラメータはすべてここにある。
本体に入る前に、もっと根本的な問いに答えておく価値がある。動画モデルと画像モデルの本質的な違いはどこにあるのか?
答えは「次元が1つ増えた」などという軽い話ではない。画像モデルをフレームごとに呼び出して 81 枚の画像を生成すると、各フレーム単体では美しくても、つなげて再生すると悲惨なことになる。物体の形がフレームごとに漂い、光が跳ね、背景がちらつく。業界用語では flicker と呼ぶ。時間的一貫性は、モデルが明示的にモデリングしなければならない。業界は大きく2つの道を歩んできた。分解式 attention(空間 attention と時間 attention を分け、まず各フレーム内部を整合させ、それから時間軸方向にそろえる。安いが一貫性には天井がある)と、完全な 3D joint attention(全フレームの全 patch を同じ attention に入れ、どの token も任意の時刻・任意の位置を直接見られる。一貫性は最強だが、代償として系列長が爆発する)。Wan2.2 は後者を選んだ。この選択が、本章の主役を直接導く。75600 token の系列だ。
latent から token へ
latent は DiT に入る前に、まず patch に切られる(この工程を patchify と呼ぶ)。model.py では、カーネルサイズと stride が同じ Conv3d になっている。
self.patch_embedding = nn.Conv3d(
    in_dim, dim, kernel_size=patch_size, stride=patch_size)
patch_size = (1, 2, 2)。時間方向は切らず、空間方向では latent の 2×2 ブロックごとに畳み込み、5120 次元の token にする。総数を数えるとこうなる。
latent 1フレームあたりの token 数 = 90 × 160 / (2×2) = 3600
総 token 数                       = 3600 × 21 フレーム = 75600
75600。これが 5 秒 720p 動画を生成するときの self-attention の系列長だ。SDXL が 1024 画像を1枚生成するときの系列長は 4096 なので、動画は画像より 18 倍長い。attention の計算量は系列長の二乗で増えるため、長さ 18 倍は attention コスト 340 倍を意味する。後で述べるあらゆる VRAM 問題や sequence parallel の根っこには、この数字がある。
14B はどう数えるのか
設定では dim=5120, ffn_dim=13824, num_layers=40 となっている。各層のパラメータの大きな部分は次の通り。
self-attention:  Q/K/V/O の4行列 = 4 × 5120² ≈ 1.05 億
cross-attention: 同じく4行列     = 4 × 5120² ≈ 1.05 億
FFN:             2行列           = 2 × 5120 × 13824 ≈ 1.42 億
各層合計 ≈ 3.51 億、× 40 層 ≈ 14.05B
「A14B」の 14B はこうして出てくる。embedding や modulation パラメータは端数にすぎない。bf16 では 1 パラメータ 2 バイトなので、1つの expert で 28GB。t2v-A14B には expert が2つある(理由は第六章で述べる)ため、DiT の重みだけで 56GB になる。そこに T5 の 11.4GB、VAE、サンプリング中の activation が加わり、80GB 単一 GPU の下限がこうして埋まっていく。
1つの block の完全な forward
WanAttentionBlock.forward はモデル全体の最小反復単位で、1行ずつ読む価値がある。読む前に1つ注意しておくと、引数 e は timestep t から来ている。第一章のあの物差し上の目盛りであり、999 はほぼ純粋なノイズ、0 は完成映像だ。これがどう e になるかは、コードの後ですぐ説明する。
def forward(self, x, e, seq_lens, grid_sizes, freqs, context, context_lens):
    assert e.dtype == torch.float32
    with torch.amp.autocast('cuda', dtype=torch.float32):
        e = (self.modulation.unsqueeze(0) + e).chunk(6, dim=2)
    assert e[0].dtype == torch.float32

    # self-attention
    y = self.self_attn(
        self.norm1(x).float() * (1 + e[1].squeeze(2)) + e[0].squeeze(2),
        seq_lens, grid_sizes, freqs)
    with torch.amp.autocast('cuda', dtype=torch.float32):
        x = x + y * e[2].squeeze(2)

    # cross-attention & ffn function
    def cross_attn_ffn(x, context, context_lens, e):
        x = x + self.cross_attn(self.norm3(x), context, context_lens)
        y = self.ffn(
            self.norm2(x).float() * (1 + e[4].squeeze(2)) + e[3].squeeze(2))
        with torch.amp.autocast('cuda', dtype=torch.float32):
            x = x + y * e[5].squeeze(2)
        return x

    x = cross_attn_ffn(x, context, context_lens, e)
    return x
構造は3段階だ。Self-Attention(75600 個の token が互いに見合い、時空間的一貫性を作る)、Cross-Attention(テキスト context を見て意味を注入する)、FFN。本当に語る価値があるのは、あの e だ。これは 6 つに chunk され、それぞれ次のように使われる。
| 使われる場所 | 役割 | |
|---|---|---|
| e[0], e[1] | self-attn 前の norm | shift と scale、norm(x) * (1+scale) + shift |
| e[2] | self-attn 出力 | gate、この枝を残差にどれだけ加えるかを制御 |
| e[3], e[4] | FFN 前の norm | 上と同じ shift/scale |
| e[5] | FFN 出力 | gate |
この 6 組のパラメータはどこから来るのか。スカラーの t(たとえば 927)は、まず標準的な正弦波エンコーディングで 256 次元に展開される。ネットワークは単一スカラーの分解能が低いため、展開後は高周波チャネルが細粒度を、低周波チャネルが粗粒度を担当する。その後、MLP と projection を通る。
self.time_embedding = nn.Sequential(
    nn.Linear(freq_dim, dim), nn.SiLU(), nn.Linear(dim, dim))
self.time_projection = nn.Sequential(nn.SiLU(), nn.Linear(dim, dim * 6))
dim * 6 が、まさにその 6 つの modulation だ。この手法は AdaLN(adaptive layer norm) と呼ばれ、DiT 論文の中核的な貢献の1つである。t を token として系列に連結するのではなく、t に各層の正規化の scale、shift、残差 gate を調整させる。直感的には第一章の denoising 軌道に戻ればよい。t=999 の入力はほぼ純粋なノイズなので、ネットワークは大胆に動くべきだ。t=10 では画面はほぼ形になっているので、ネットワークは微調整だけをすべきだ。同じ重みの集合が、t に応じて変化するこの 6 組のパラメータによって振る舞いのモードを切り替える。同じ料理人が、仕上がり時刻に応じて自動的に火加減を変えるようなものだ。DiT 論文では、「t を token として連結する」方式と「AdaLN で modulation する」方式を比較しており、同じ計算量では後者のほうが FID が明らかに良かった。それ以降、これは diffusion transformer の標準的な書き方になった。
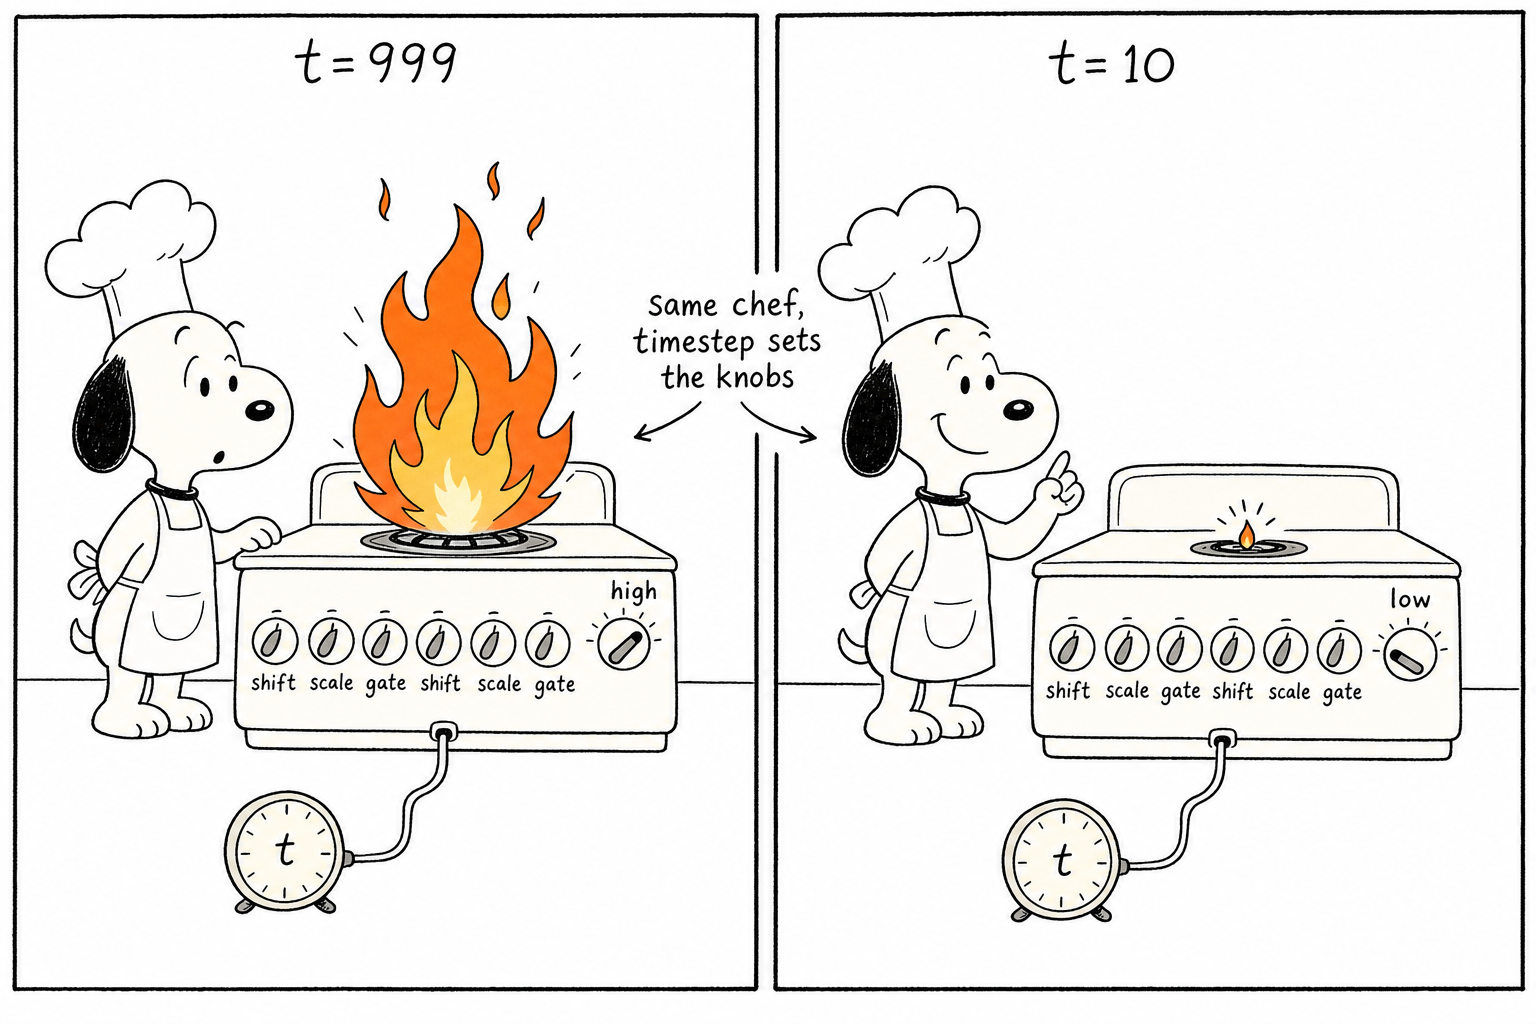
コードにはもう1つ見落としやすい細部がある。すべての modulation 演算が autocast float32 で囲まれていることだ。主幹は bf16 で走らせられるが、この modulation の数ステップは強制的に全精度になる。denoising は数十ステップの反復過程なので、modulation パラメータの数値誤差は少しずつ蓄積する。これは作者が VRAM を払って安定性を買っている場所だ。
3D RoPE: token に自分の位置を知らせる
75600 個の token は一次元の系列に並べられるが、attention 自体は誰が誰の隣にいるのかを知らない。位置情報は RoPE(rotary positional embedding)で注入される。動画版の特殊な点は、座標軸が3つあることだ。構築時には、各 head の 128 次元を3つに分ける。
d = dim // num_heads          # 5120 // 40 = 128
self.freqs = torch.cat([
    rope_params(1024, d - 4 * (d // 6)),   # 時間軸: 44 次元
    rope_params(1024, 2 * (d // 6)),       # 高さ軸: 42 次元
    rope_params(1024, 2 * (d // 6))        # 幅軸: 42 次元
], dim=1)
適用時には、各 token が自分の (f, h, w) という3つの座標に応じて3区間の回転量を取り出し、それらをつないで完全な 128 次元の回転を作り、複素数乗算で q と k に一度に適用する。attention が q·k の内積を計算するとき、回転の相対性により、内積は2つの token の座標差だけに依存する。画面全体を2マス平行移動しても、すべての相対関係は変わらず、モデルが学んだ規則はそのまま使える。平行移動不変性がただで手に入るわけだ。これは画像の 2D RoPE を動画へ直接拡張したものであり、44/42/42 という配分は、時間軸が単一の空間軸とほぼ同じだけの周波数チャネルを受け取ることを意味する。時間関係と空間関係は同等に扱われている。
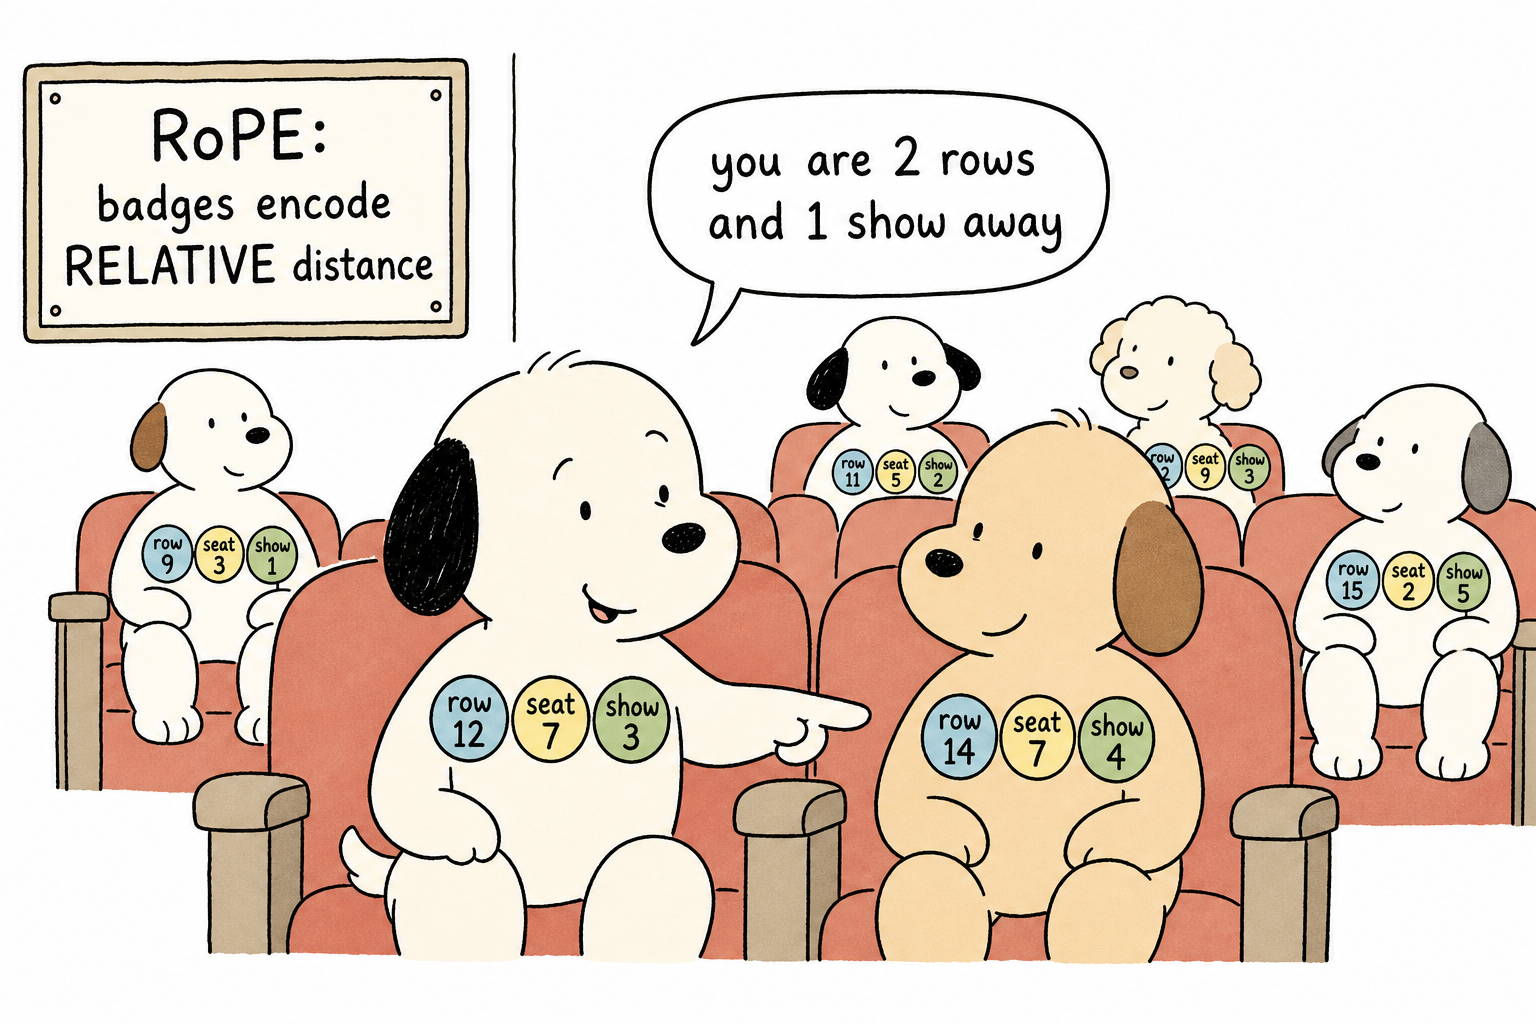
細部: 回転の実装(rope_apply)は全過程を float64 で行い、autocast も明示的に無効化している。回転は純粋な幾何演算であり、半精度の位相誤差は長い系列では増幅される。ここもまた、計算量を払って数値安定性を買うトレードオフだ。さらに WanSelfAttention では、q と k が線形層を通ったあと、それぞれ RMSNorm(QK-Norm)を接続している。内積のスケールを固定し、softmax の飽和を防ぐためだ——推論コードだけを見るとその価値は分かりにくいが、これがないと 14B 規模の DiT を安定して訓練するのは難しい。
1回の forward における形状の帳尻
章全体を1つの表につなげると、データがモデルに入ってから出てくるまでの各変形はこうなる(t2v-A14B、81 フレーム 720p、単一 GPU):
| 段階 | テンソル形状 | 説明 |
|---|---|---|
| ノイズ付き latent | 16 × 21 × 90 × 160 | 第2章の VAE が定義した空間 |
| patch_embedding(Conv3d) | 5120 × 21 × 45 × 80 | 空間方向の 2×2 を畳み込んで1つの位置にする |
| 系列へ平坦化 | 75600 × 5120 | 21×45×80 = 75600 |
| 40 × WanAttentionBlock | 75600 × 5120 | 形状は不変で、内容を繰り返し精緻化する。各層内部では q/k/v を 40 heads × 128 次元に分割し、RoPE は q と k だけを回転する |
| Head | 75600 × 64 | 64 = patch 体積(1×2×2)× 16 チャネル |
| unpatchify | 16 × 21 × 90 × 160 | latent の形状へ折り戻す |
どんな形状で入ったか、そのまま同じ形状で出てくる。途中は 40 層の等幅な精緻化だ。出力の意味は第1章で述べた速度であり、入力 latent と位置ごとに対応している。各位置の値は「この位置の内容をどちらの方向へ動かすべきか」を示す。テキスト context(512 × 4096 が text_embedding を経て 512 × 5120 へ射影される)は、全過程で cross-attention の key/value としてのみ存在し、系列位置は占有しない。
ここまでで、「ノイズ付き latent と t を受け取り、速度予測を吐く」この機械は完成した。次章では、この予測がサンプリングループでどう使われるかを見る。
第5章 サンプリングループ:40 ステップ、各ステップで2回の forward
機械は毎回ひとつの方向だけを告げる。動画を本当にノイズの中から歩かせて取り出すのは、その周囲を回るループだ。40 個の停留点を選び、各点で2回道を尋ねる。
UniPC:速く、かつ安定して進むには
速度場があっても、まだ数値積分器が必要だ。各ステップでモデルが報告した速度を受け取り、前へどれだけ動かすかを決める。このコンポーネントはコード上では scheduler と呼ばれ、fm_solvers_unipc.py がそれにあたる。もっとも素朴な積分はオイラー法で、各ステップで速度が一定だと仮定し、x ← x - Δσ·v とする。一次精度であり、実際の速度場は曲がっているため、歩幅が大きいほどずれも大きくなる。Wan2.2 がデフォルトで使う UniPC は、多段の予測・補正器だ。predictor は直近2ステップ(設定は solver_order=2)のモデル出力から速度の変化傾向をフィットし、外挿して次のステップへ進む。corrector は新しい位置でのモデル出力が計算されたあと、直前の一歩を振り返って修正する。追加の forward なしで一次分の精度を拾える。同じ 40 回のモデル呼び出しでも、局所誤差はオイラーの一次小量から三次へ下がる。「許容できる品質」に必要なステップ予算が数百から数十へ削られるのは、こういう仕組みだ。動画生成では各ステップが 14B の forward 2回なので、節約できる1ステップ1ステップがそのままコスト削減になる。
shift:40 個の停留点をどこに置くか
scheduler は 40 個のサンプリング点の位置も決める。set_timesteps はまず点を一様に敷き、その後 shift 変換をかける。
sigmas = shift * sigmas / (1 + (shift - 1) * sigmas)
この変換は点を高ノイズ側(σ が大きい側)へ押し寄せる。どの程度寄るかは中央値を見ると分かる。
| shift | 中央時刻ステップ |
|---|---|
| 1(寄せない) | 512 |
| 5 | 840 |
| 12(t2v デフォルト) | 926 |
shift=12 では、サンプリング点の半分が t>926 の区間に落ちる。実際の時刻ステップ列の冒頭はこうなる(shift=12、40 ステップ。set_timesteps を自分で走らせれば検証できる。出力は整数に丸めている)。
999, 997, 995, 993, 990, 988, ...
最初の数ステップの間隔は 2 前後しかなく、非常に細かく進む。一方で低ノイズ段階に入ると間隔は数十まで広がり、数ステップで一気に渡り切る。
なぜこう配分するのか。高ノイズ段階は構図、物体、動きの方向性を決める、「無から有へ」の段階だからだ。低ノイズ段階は細部を磨くだけである。難しい段階へ予算を傾けるのは、動画生成が画像生成よりさらに必要とするトレードオフだ。画像の shift は通常 3 前後だが、動画は動きの一貫性がはるかに難しいため、Wan2.2 は直接 12 まで引き上げている。同じリポジトリでも i2v は 5.0(最初のフレームがすでに与えられており、構造上の負荷が小さい)、ti2v-5B は 5.0、s2v は 3 だ。各タスクの shift は、それぞれの難しさの分布を物語っている。--sample_shift はステップ数を変えず、ステップをどう配分するかだけを変える。つまり調整することは、「構造をより安定させる」ことと「細部をより精密にする」ことの間で予算を動かすのに等しい。これは次章の専門家分担とも強く噛み合っているので、数字上の勘定はそこで改めて見る。
CFG:各ステップでなぜ forward を2回走らせるのか
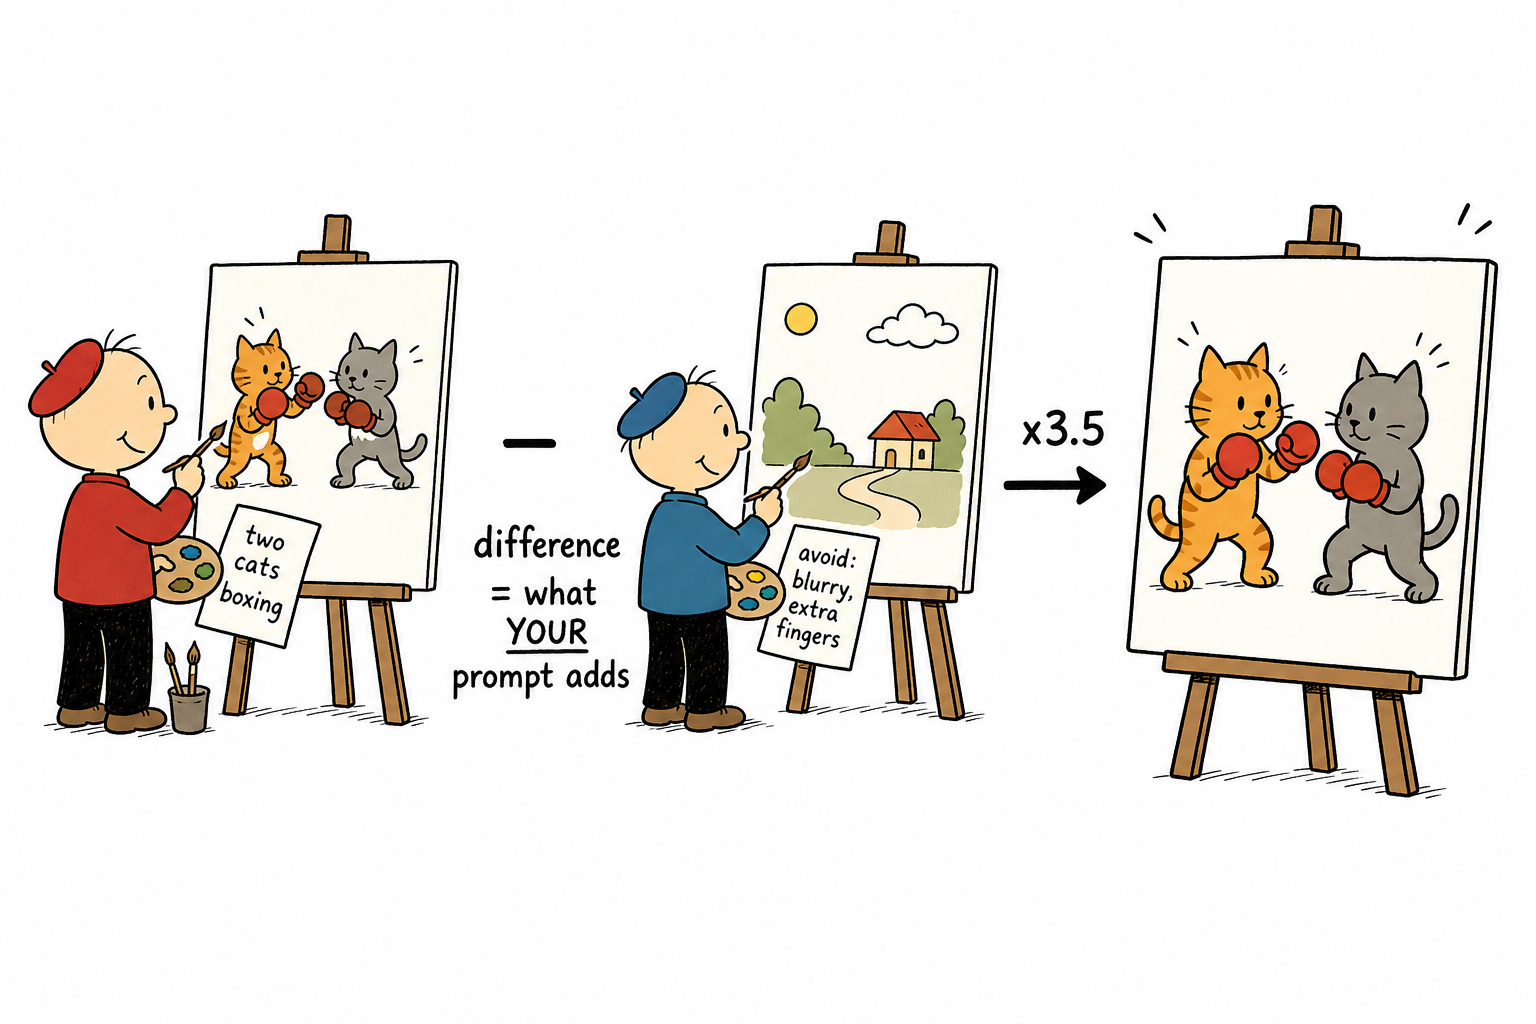
サンプリングループの核心(text2video.py):
noise_pred_cond = model(latent_model_input, t=timestep, **arg_c)[0]
noise_pred_uncond = model(latent_model_input, t=timestep, **arg_null)[0]

noise_pred = noise_pred_uncond + sample_guide_scale * (
    noise_pred_cond - noise_pred_uncond)
同じ latent、同じ t で2回走らせる。1回はあなたの prompt 付き(arg_c には context が入る)、もう1回は負の prompt 付き(arg_null には context_null が入る)。これが classifier-free guidance(CFG) だ。
原理は数学を一段だけ展開すると分かりやすい。「条件 c に合うサンプル」を生成することは、ベイズの式でこう分解できる。
p(x|c) ∝ p(x) · p(c|x)
対数を取り、勾配(score)を求める。
∇log p(x|c) = ∇log p(x) + ∇log p(c|x)
第一項は無条件の方向(データそのものがどんな姿をしているか)、第二項は「x を条件 c に属するものらしくする」分類器勾配だ。初期の手法では、この勾配を提供するために本当に専用の分類器を訓練していたが、高価で訓練も難しかった。CFG の洞察は、この項をただで手に入れられるという点にある。モデルは条件付き予測と無条件予測の両方を同時に学んでいる(訓練時にランダムにテキストを落とせばよい)。両者を引き算すると、
∇log p(c|x) = ∇log p(x|c) - ∇log p(x) ≈ cond 予測 - uncond 予測
分類器勾配は、2回の forward の差分の中に隠れている。サンプリング時には、この項を w 倍に拡大する。
最終方向 = uncond + w · (cond - uncond)
前に貼った3行のコードと照らせば、まったく同じだ。sample_guide_scale が w である。
w の選び方は純粋なトレードオフだ。w=1 では条件付き生成に退化し、画面は自然だが prompt を「聞き取れていない」ことがよくある。w を高くすると、モデルは「分類器がより確信する」領域へ強く押し出され、構図の従順さは上がる。その代償として、色の過飽和、細部のぼやけ、動きの硬さが出やすい。latent が訓練分布の高密度領域から押し離されるからだ。画像モデルでは 7 前後がよく使われるが、動画は時系列の自然さにより敏感であるため、Wan2.2 の A14B 双専門家シリーズでは 3.0〜4.0 しか使わない(ti2v-5B は 5.0、s2v は 4.5)。
負の prompt がこの導出の中でどこに位置するかも明確になる。標準的な CFG の uncond は空テキストを使う。Wan2.2 はそれを、「露出過多、変形、三本足」といった記述の列に置き換えている。これにより差分方向は、「あなたの prompt に近づく」から、「あなたの prompt に近づき、かつそれらの欠陥から遠ざかる」へ変わる。1回の forward が同時に2つの仕事をしている。
コストも同じく明確だ。40 ステップ × forward 2回 = 80 回 の 14B モデル完全推論。動画生成が遅い理由の半分は、CFG に計上される。
第六章 2つの 14B 専門家によるリレー
前章のノイズ除去ループと CFG は、背後で1つのモデルが走っている前提だった。実は A14B シリーズには2つのモデルが隠れている。この章では、その2つがどう分担するのか、そしてそれがなぜあなたの GPU で動くかどうかを直接決めるのかを説明する。
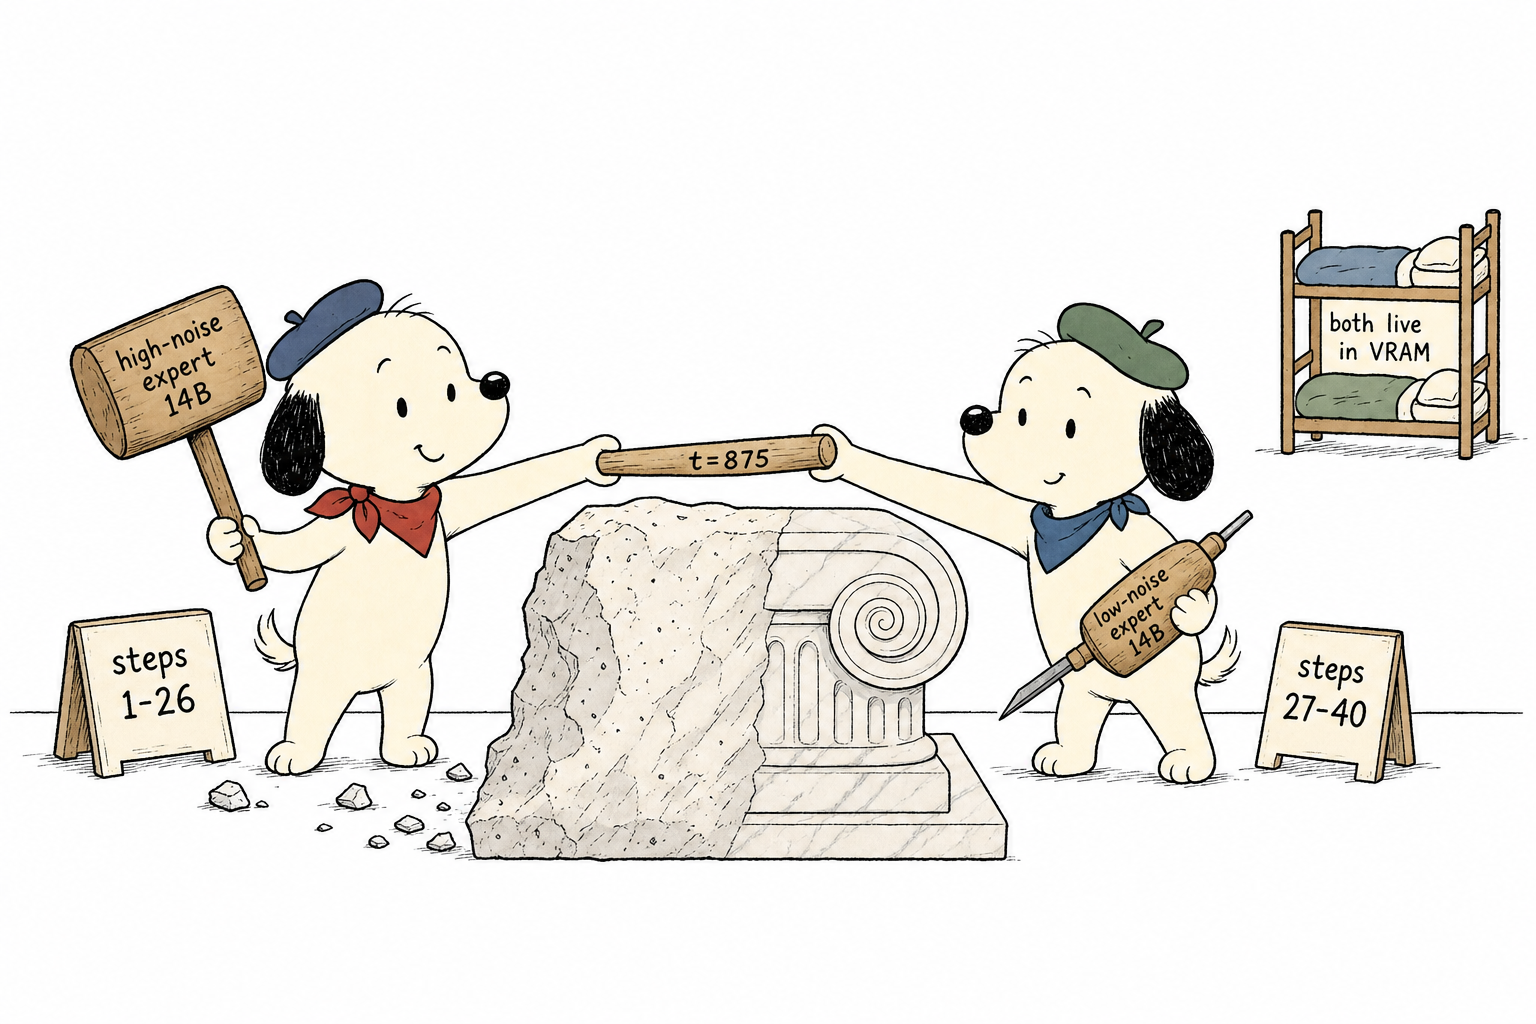
Wan2.2 A14B シリーズの看板設計は、2つの 14B 専門家が異なるノイズ区間を分担して走ることだ。設定ではこうなっている。
t2v_A14B.boundary = 0.875
t2v_A14B.sample_guide_scale = (3.0, 4.0)  # low noise, high noise
サンプリングループは各ステップで t >= 0.875 × 1000 かを判定する。成立すれば high_noise_model、そうでなければ low_noise_model を使う。設計動機は第五章の観察に続いている。高ノイズ段階では混沌の中から構造を決め、低ノイズ段階では半完成品の上で質感を磨く。1つのネットワークに2つの仕事を同時に熟達させるより、2つのネットワークにそれぞれ1つずつ極めさせたほうがよい。しかもこの分担は第一層から成立している。高ノイズ専門家への入力はほぼ純粋なガウスノイズで、前半の層は「統計から構造を推測する」。低ノイズ専門家への入力はすでに半完成品で、前半の層は「既存の画面を読み解く」。入力分布がこれほど違うなら、底層を共有しても互いの足を引っ張るだけだ。だから2つの専門家は完全に独立しており、それぞれのノイズ区間で別々に学習され、推論時には t に応じてリレーする。
これが公式の「総パラメータ 27B、活性化 14B」の意味だ(27B は厳密な口径で、第四章の 14.05B は各層の大物だけを数えたもの)。容量は2倍だが、どのステップでも走る専門家は1つだけなので、計算コストは 14B の dense モデルと同じになる。「MoE」という言葉に惑わされてはいけない。Mixtral のような LLM MoE は、各層・各 token ごとに学習済み router で専門家を選ぶ。ここでは時間ステップ単位のルーティングで、閾値は固定、router すら存在せず、実装全体はただの if だ。粗い粒度にしたことで2つの利点がある。拡散の時間ステップは自然に難易度ラベルになるため router を訓練しなくてよいこと、そして2つの専門家を独立に訓練し、独立に更新できることだ。
完全なサンプリングループを貼ると、これまでの各章で説明した部品がこの20行に合体している。
for _, t in enumerate(tqdm(timesteps)):
    latent_model_input = latents
    timestep = [t]

    timestep = torch.stack(timestep)

    model = self._prepare_model_for_timestep(
        t, boundary, offload_model)
    sample_guide_scale = guide_scale[1] if t.item(
    ) >= boundary else guide_scale[0]

    noise_pred_cond = model(
        latent_model_input, t=timestep, **arg_c)[0]
    noise_pred_uncond = model(
        latent_model_input, t=timestep, **arg_null)[0]

    noise_pred = noise_pred_uncond + sample_guide_scale * (
        noise_pred_cond - noise_pred_uncond)

    temp_x0 = sample_scheduler.step(
        noise_pred.unsqueeze(0), t,
        latents[0].unsqueeze(0),
        return_dict=False, generator=seed_g)[0]
    latents = [temp_x0.squeeze(0)]
各ラウンドでやることは5つだ。専門家を選ぶ、guide scale を選ぶ、2回 forward する、CFG で合成する、scheduler を1歩進める。_prepare_model_for_timestep には、単一 GPU 救済用の offload ロジックもある。
if offload_model or self.init_on_cpu:
    if next(getattr(self, offload_model_name).parameters()).device.type == 'cuda':
        getattr(self, offload_model_name).to('cpu')
    if next(getattr(self, required_model_name).parameters()).device.type == 'cpu':
        getattr(self, required_model_name).to(self.device)
--offload_model True を有効にすると、専門家を切り替えるたびに、退勤するほうをメインメモリへ戻し、出勤するほうを GPU に載せる。28GB の重みを PCIe で一度通すには数秒かかるが、幸いサンプリング全体では一度しか切り替わらない(t は単調に下がり、boundary をまたいだら戻らない)ので、このコストは一度きりで済む。
boundary と shift の連動
これは調整時に最も見落としやすい勘定だ。boundary=0.875 は字面だけ見ると「高ノイズ専門家に割り当てられるのは時間ステップの 12.5% だけ」に見える。しかし第五章で述べたように、shift はサンプリング点を高ノイズ側へ強く押し込む。t≥875 を境に、40 ステップの所属を数えるとこうなる。
| shift | 高ノイズ専門家のステップ数(t ≥ 875) |
|---|---|
| 1 | 5 / 40 |
| 5 | 17 / 40 |
| 12(t2v デフォルト) | 26 / 40、65% |
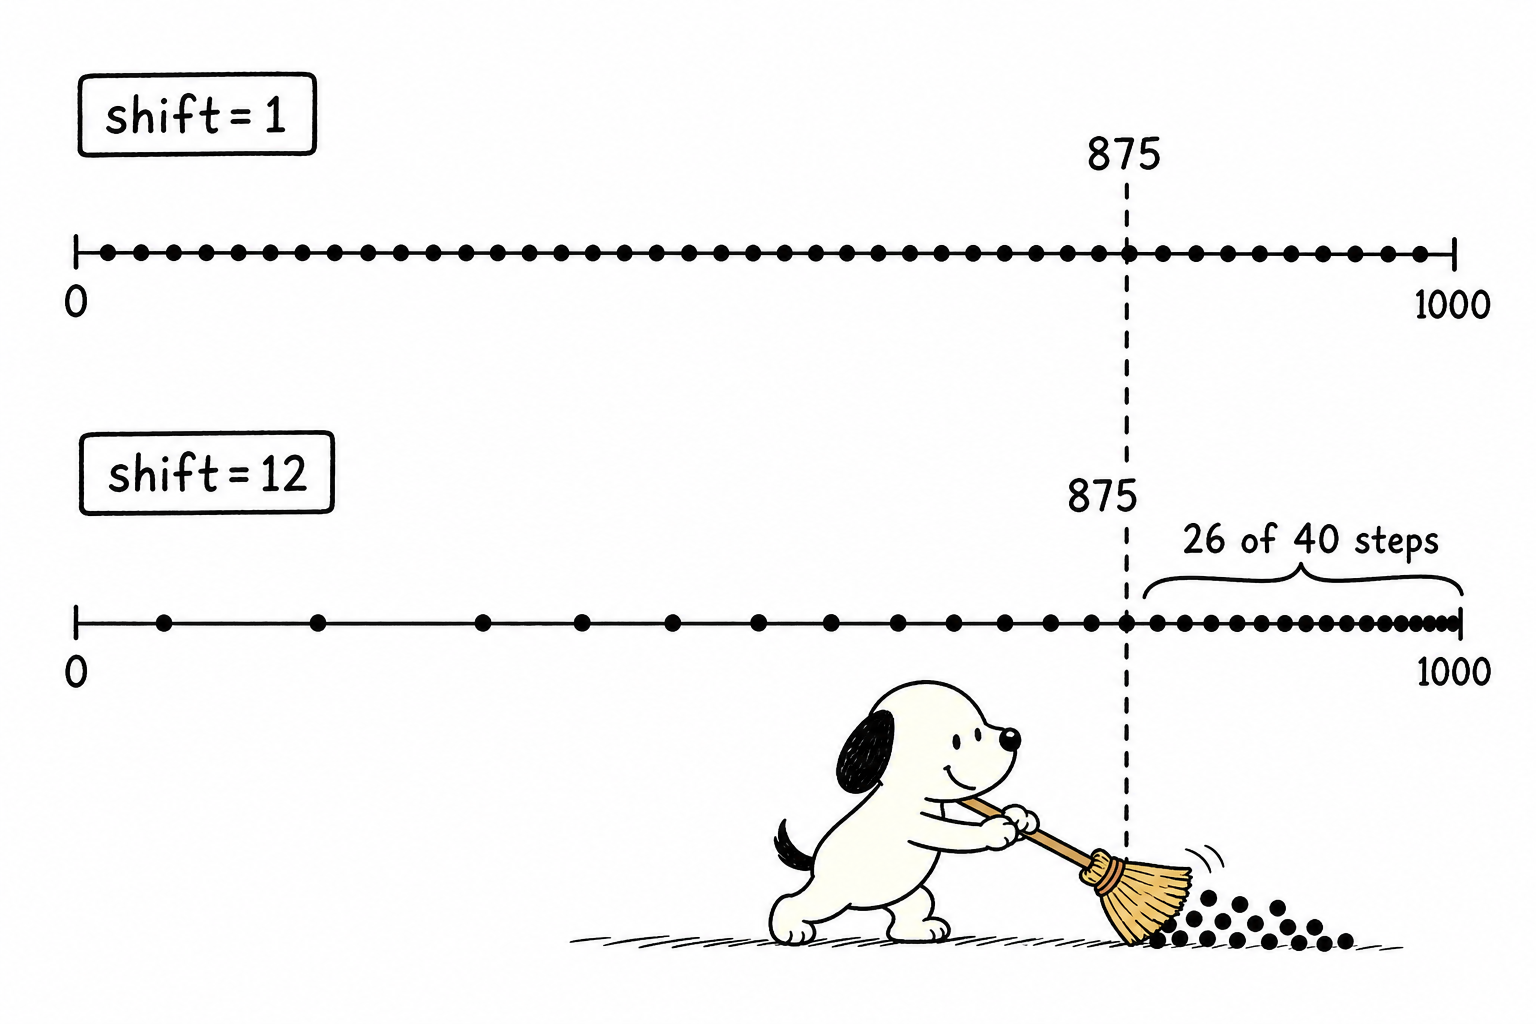
予算の大部分は、構造を決める高ノイズ専門家に渡される。低ノイズ専門家は残り14ステップで仕上げる。--sample_shift だけを調整して boundary を動かさないと、2つの専門家の作業量配分が静かに変わり、生成品質の揺れの理由がわからなくなる。2段階の guide_scale も分担のためにある。高ノイズ段階では 4.0 を使い(構造段階で prompt に強く寄せる)、低ノイズ段階では 3.0 に下げる(細部段階では押し付けを弱め、画面をより自然にする)。
最後に、よくある誤解を整理しておく。各 timestep で登場する専門家は1つだけで、2回の forward は CFG の cond/uncond である。専門家同士が同じステップで同時に働くことはない。「各ステップで2回 forward」と「双専門家」は直交する別の話だ。
VRAM 勘定と三点セット
もう一度計算する。2つの専門家の bf16 重みで 56GB、T5 encoder が 11.4GB、VAE と activations、KV がいくらか。80GB カードならぎりぎり収まる。単一 GPU で動かないときの三点セットは、それぞれ勘定上の項目に対応している。--offload_model True は現在使っていない専門家をメインメモリへ戻す(常駐 28GB を削る)。--t5_cpu は T5 をメインメモリに置き、エンコード時だけ GPU に載せる(11.4GB を削る)。--convert_model_dtype は重み精度を下げる。
どう組み合わせるかについては、README のサンプルコマンドが公式の答えを示している。単一 GPU で A14B を走らせる例は、それ自体が --offload_model True --convert_model_dtype 付きだ(かつ最低 80GB VRAM と注記されている)。4090 で ti2v-5B を走らせる場合は三点すべてを足す(--t5_cpu も有効にする。5B の場面では T5 の 11.4GB の比率がむしろ最大になる)。README の ti2v-5B 節には逆方向の注意もある。VRAM が 80GB を超える場合はこれらの flag を外すと明らかに高速化する。offload は無料ではない。
第七章 条件注入:画像から動画ではどの数行が変わったか
ここまでで、テキストから動画生成の完全な流れはすでに通った。残る四つのタスク(画像から動画、テキスト画像統合、音声、アニメーション)は四組の新しいモデルではなく、この同じ一本のバックボーンに別々の「問題文」を差し替えているだけだ。
条件を加える方法は、大きく三つしかない。
- cross-attention:テキストが通る道。条件は key/value として注意される
- チャネル連結:条件テンソルをノイズ latent とチャネル次元で直接つなぎ、まとめて patch embedding に入れる
- AdaLN:条件をタイムステップ embedding に混ぜ、各層の norm を変調する
画像から動画(i2v-A14B)が使うのは二つ目だ。image2video.py で条件をどう作っているかを見る。
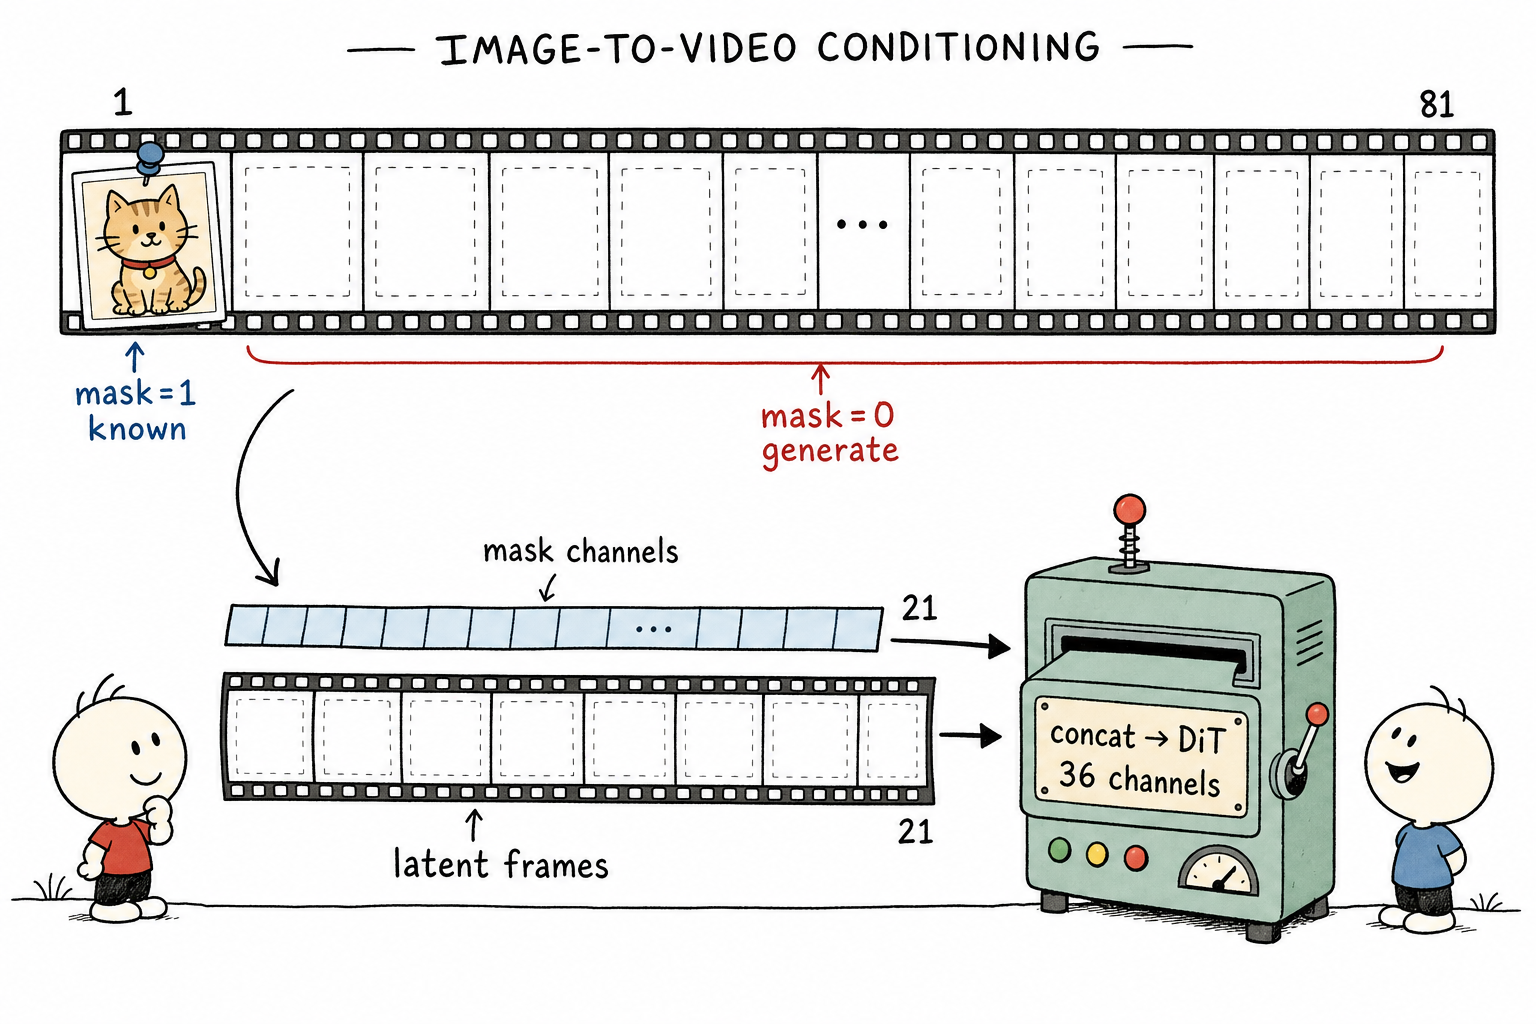
msk = torch.ones(1, F, lat_h, lat_w, device=self.device)
msk[:, 1:] = 0
msk = torch.concat([
    torch.repeat_interleave(msk[:, 0:1], repeats=4, dim=1), msk[:, 1:]
], dim=1)
msk = msk.view(1, msk.shape[1] // 4, 4, lat_h, lat_w)
msk = msk.transpose(1, 2)[0]
...
y = torch.concat([msk, y])
行ごとに分解する。msk は「どのフレームが既知か」を示す印だ。1 フレーム目(入力画像)は 1、残りの 80 フレームは 0 にする。次の repeat_interleave と reshape の列がやっていることは一つだけ。81 フレームぶんのピクセル単位 mask を、21 フレームの latent 時間軸へ畳み込んでいる。第二章の VAE の圧縮規則を覚えているだろうか。最初の 1 フレームは単独で 1 latent フレームを占め、その後は 4 フレームごとに一つへまとめられる。mask も同じ規則で畳む必要がある。最初のフレームを 4 回コピーしてグループを埋め、さらに 4 フレームずつの組に折りたたむことで、latent と揃った 4×21×h×w を得る。
y は入力画像そのものを VAE encoder に通した結果だ(足りないフレームはゼロで埋める)。mask と y をつなぐと合計 20 チャネルになり、さらに 16 チャネルのノイズ latent とチャネル次元でもう一度連結してモデルに入れる。model.py の forward 冒頭はこうだ。
if y is not None:
    x = [torch.cat([u, v], dim=0) for u, v in zip(x, y)]
i2v 版の WanModel の入力チャネル数は 36(16 ノイズ + 16 画像 latent + 4 mask)だ。patch embedding の最初の畳み込みは t2v 版より横に広いが、残り 40 層の構造は完全に同じ。画像から動画でバックボーンに加わる変更は、入力チャネルが 16 から 36 になることだけである。
モデルがこの 36 チャネルから学ぶ振る舞いはこうだ。mask=1 の位置では与えられた内容をそのまま写し、mask=0 の位置では生成し、その両者が時間的・空間的につながるようにする。最初のフレームが画面の主体とスタイルを固定し、後ろの 80 フレームがそれを中心に動きを展開する。これが「画像を動かす」仕組みだ。
他のタスクの条件はどこから来るか
同じ考え方で残り三つのタスクを読む。見るべきポイントは「条件が何で、モデルのどの入口から入るか」だ。
ti2v-5B(テキスト画像統合)。同じ 5B バックボーンに 4×16×16 の高圧縮 VAE を組み合わせ、アーキテクチャを変えずに t2v と i2v を同時にサポートする。画像が与えられれば、それをエンコードして latent の第 1 フレーム位置に固定し、mask で既知として印を付ける。画像がなければ、純粋なノイズから始める。一つのモデルに二つの顔がある。
s2v-14B(音声駆動)。条件は音声だ。wav2vec2 が波形をフレームごとの特徴に変換し、動画フレームレートに合わせて再ビン分けしてからモデルへ注入し、口形や身体のリズムを駆動する。動画の長さは音声に追従する。超長尺の音声は複数区間に分けて自己回帰的に生成し、各区間では前区間末尾の数フレームの latent を「運動量条件」として受け取り、つなぎ目を接続する。これはリポジトリ内で唯一の長尺動画方式だ。
animate-14B(キャラクターアニメーション/置換)。条件が最も重いタスクだ。骨格姿勢列が動作を駆動し、顔特徴列が表情を駆動し、参照画像は CLIP の視覚エンコードを経由して cross-attention に入り、見た目を固定する。置換モードでは、さらに背景動画と mask もあり、複数の条件がそれぞれ別々の入口を通る。
条件の由来はさまざまだが、注入手法は結局その三つの繰り返しだ。空間的に揃った条件(mask、姿勢、背景など)はチャネル連結、グローバルな意味条件(テキスト、参照画像特徴など)は cross-attention、時系列に揃った条件(音声など)はフレームごとの特徴注入。一つのタスクが読めれば、残りはすべてその組み合わせである。
第八章 75600² とは何か
モデルがどう動くか、どう条件を足すかは、すべて説明した。残るのは純粋なエンジニアリング上の問題だ。これほど大きな計算量を、1 枚のカードで受け止められないならどうするか。この章では第四章の 75600 に戻り、それがどのようにマルチカード構成を必要にするのかを見る。
attention の勘定をもう少し細かく計算する。単層 self-attention の中核計算は QK^T と AV の 2 回の行列積で、FLOPs はおおよそ
2 × 2 × L² × dim = 4 × 75600² × 5120 ≈ 1.17 × 10¹⁴
となる。
(2 つの 2 の意味は、一つは行列積が 2 回あること、もう一つは各要素ペアについて乗算と加算をそれぞれ 1 FLOP と数えることだ。)1 層で 117 TFLOPs、40 層、80 回の forward となると、attention だけで 3.7 × 10¹⁷ FLOPs 規模になる。A100 1 枚の bf16 ピーク性能は約 312 TFLOPS なので、理想的な利用率でもこの部分だけで二十分ほどかかり、まだ FFN は含まれていない。これが「5 秒の動画生成に数分から数十分かかる」ことの物理的な底勘定だ。
1 枚で耐えられないなら、分割する。Wan2.2 の主力案は Ulysses シーケンス並列で、中核となる通信プリミティブは distributed/util.py にある、ある次元を入れ替える処理だ。
def all_to_all(x, scatter_dim, gather_dim, group=None, **kwargs):
    world_size = get_world_size()
    if world_size > 1:
        inputs = [u.contiguous() for u in x.chunk(world_size, dim=scatter_dim)]
        outputs = [torch.empty_like(u) for u in inputs]
        dist.all_to_all(outputs, inputs, group=group, **kwargs)
        x = torch.cat(outputs, dim=gather_dim).contiguous()
    return x
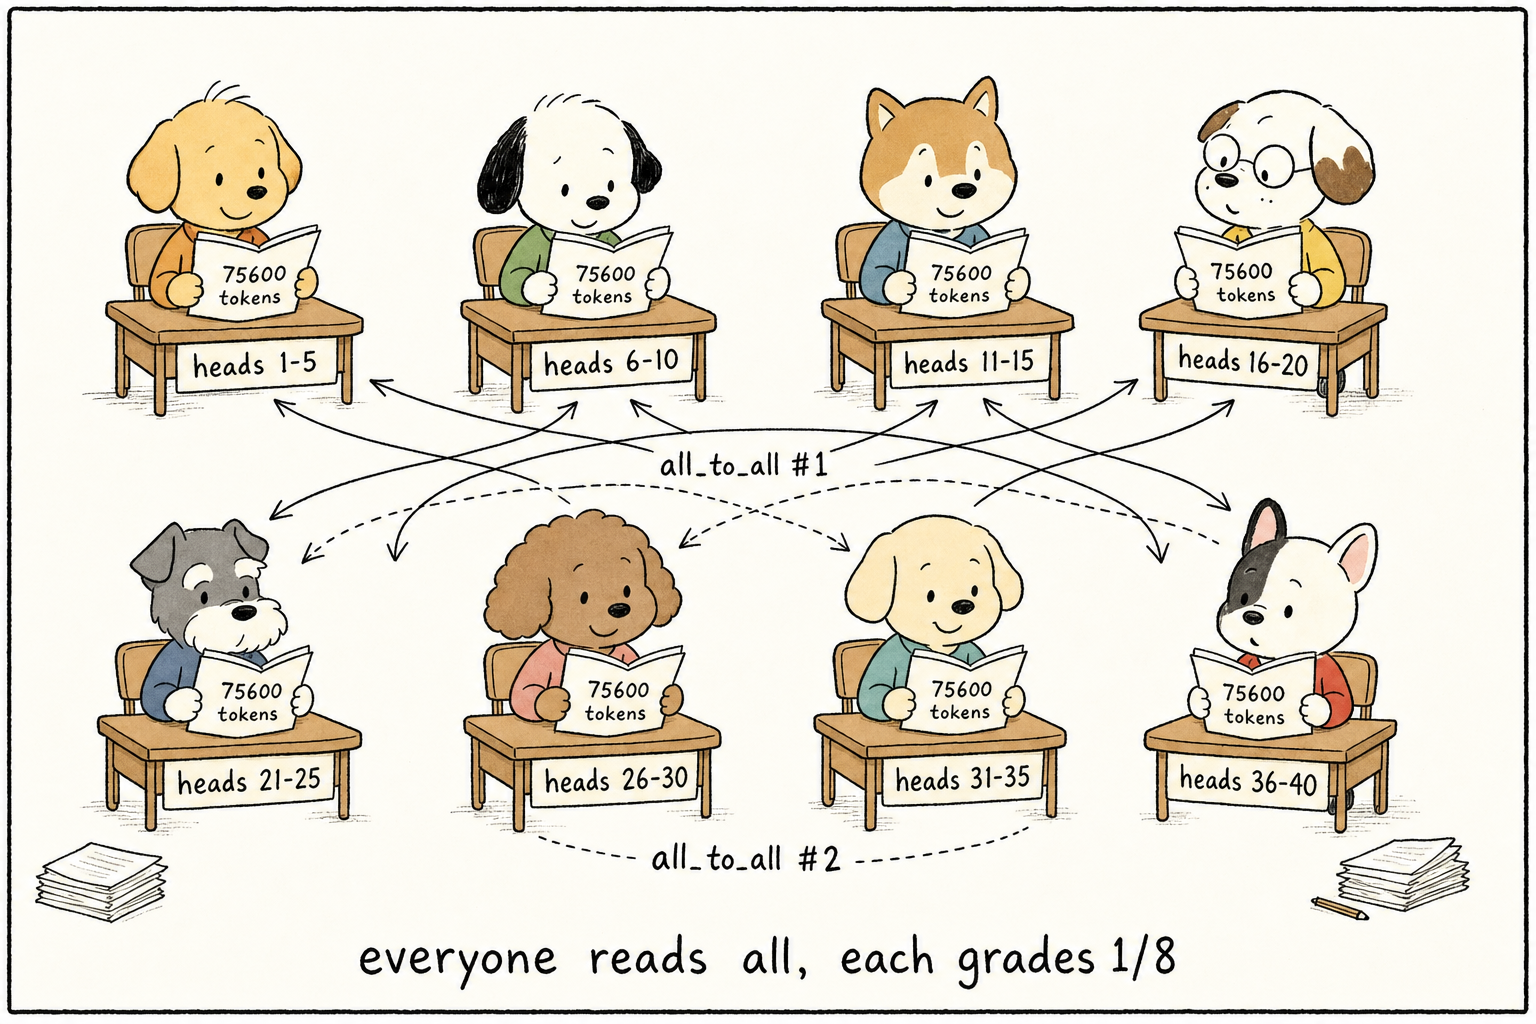
attention では各 token が完全なシーケンス全体を見る必要があるため、単純にシーケンスを切るだけでは済まない。Ulysses の答えは「シーケンスではなく head を切る」ことだ。8 枚のカードで一連の流れを走らせ、テンソル形状を追うと(B=1, L=75600, 40 heads)、次のようになる。
| 段階 | 各カードが保持するもの |
|---|---|
| block に入る前、シーケンスが分割されている | L=9450、40 heads |
| all_to_all(head 次元を scatter、sequence 次元を gather) | L=75600、5 heads |
| ローカル flash attention | 完全なシーケンス、1/8 の head |
| all_to_all で戻す | L=9450、40 heads |
通信は 2 回。その代わり、各カードは attention head の 1/8 だけを計算すればよくなり、attention の計算量と activation メモリはいずれも 1/8 まで下がる。head 数はカード数で割り切れなければならない(40 heads に 8 枚はちょうどよい)。generate.py には対応する assert がある。
シーケンス長の側にも、マルチカード向けの細部がある。text2video.py の seq_len の式の末尾には ceil(... / sp_size) * sp_size が付いており、token 数をカード数の整数倍へ切り上げる。75600 はちょうど 8 で割り切れるのでここでは変わらない。別の解像度で 75601 token になった場合は 75608 まで埋め、各カードが同じ長さのスライスを受け取れるようにする。単カードでは sp_size=1 なので、この部分は恒等変換だが、マルチカードの文脈で初めて姿を現す。
通信コストも計算できる。各層で q/k/v/output の 4 回の all_to_all があり、データ量は約 3.1GB。40 層 × 80 回の forward では累計約 10TB になる。恐ろしく聞こえるが、NVLink のカード間帯域は毎秒数百 GB 規模なので、生成全体に均すと通信時間は計算時間よりかなり小さく、この取引は割に合う。一方で PCIe のマシンでは必ずしもそうではなく、マルチカードの加速比は明らかに縮む。ついでに競合手法の Ring Attention にも触れておくと、これはシーケンスを切り、K/V をリング状に回す方式で、head 数の割り切り制約は受けないが、通信はより複雑になる。Ulysses の上限はカード数が 40 heads を超えられないことで、64 カードのクラスタでは別の方式が必要になる。
パラメータが載らない問題は、もう一つの軸だ。FSDP(fully sharded data parallel)はモデル重みを N 分割して各カードに分散配置し、forward である層を計算するときに、全カードが先に all-gather してその層のパラメータをそろえ、計算が終わったらすぐ解放する。8 カードでは各カードに常駐する DiT 重みは 56GB から 7GB まで下がる。代償は各層ごとの all-gather だが、NVLink 上ではこのオーバーヘッドの大半を計算と重ねられる。
単カードと 8 カードのメモリ勘定を並べて見ると、次のようになる。
| 項目 | 単カード(offload なし) | 8 カード(fsdp + ulysses) |
|---|---|---|
| 2 つの DiT expert 重み(bf16) | 56 GB | 7 GB / カード |
| T5 encoder 重み | 11.4 GB | shard または --t5_cpu 後はほぼ 0 |
| attention activation | 全シーケンス | 1/8 シーケンス |
| 結論 | 80GB カードでぎりぎり | ミドルクラスのカードでも可 |
シーケンス並列は計算量を担当し、FSDP はメモリを担当する。両者は直交しており、--dit_fsdp --ulysses_size 8 は同時に有効化できる。README の 8 カード用コマンドがその両方を付けているのは適当に書いたものではなく、各 flag が勘定表の一行に対応している。
第九章 モデルはなぜよくある失敗をするのか
動画生成で典型的に起きる破綻の多くは、前章までの原理で説明できる。この章では「現象」と「メカニズム」を結びつける。checklist を丸暗記するより、そのほうが役に立つ。
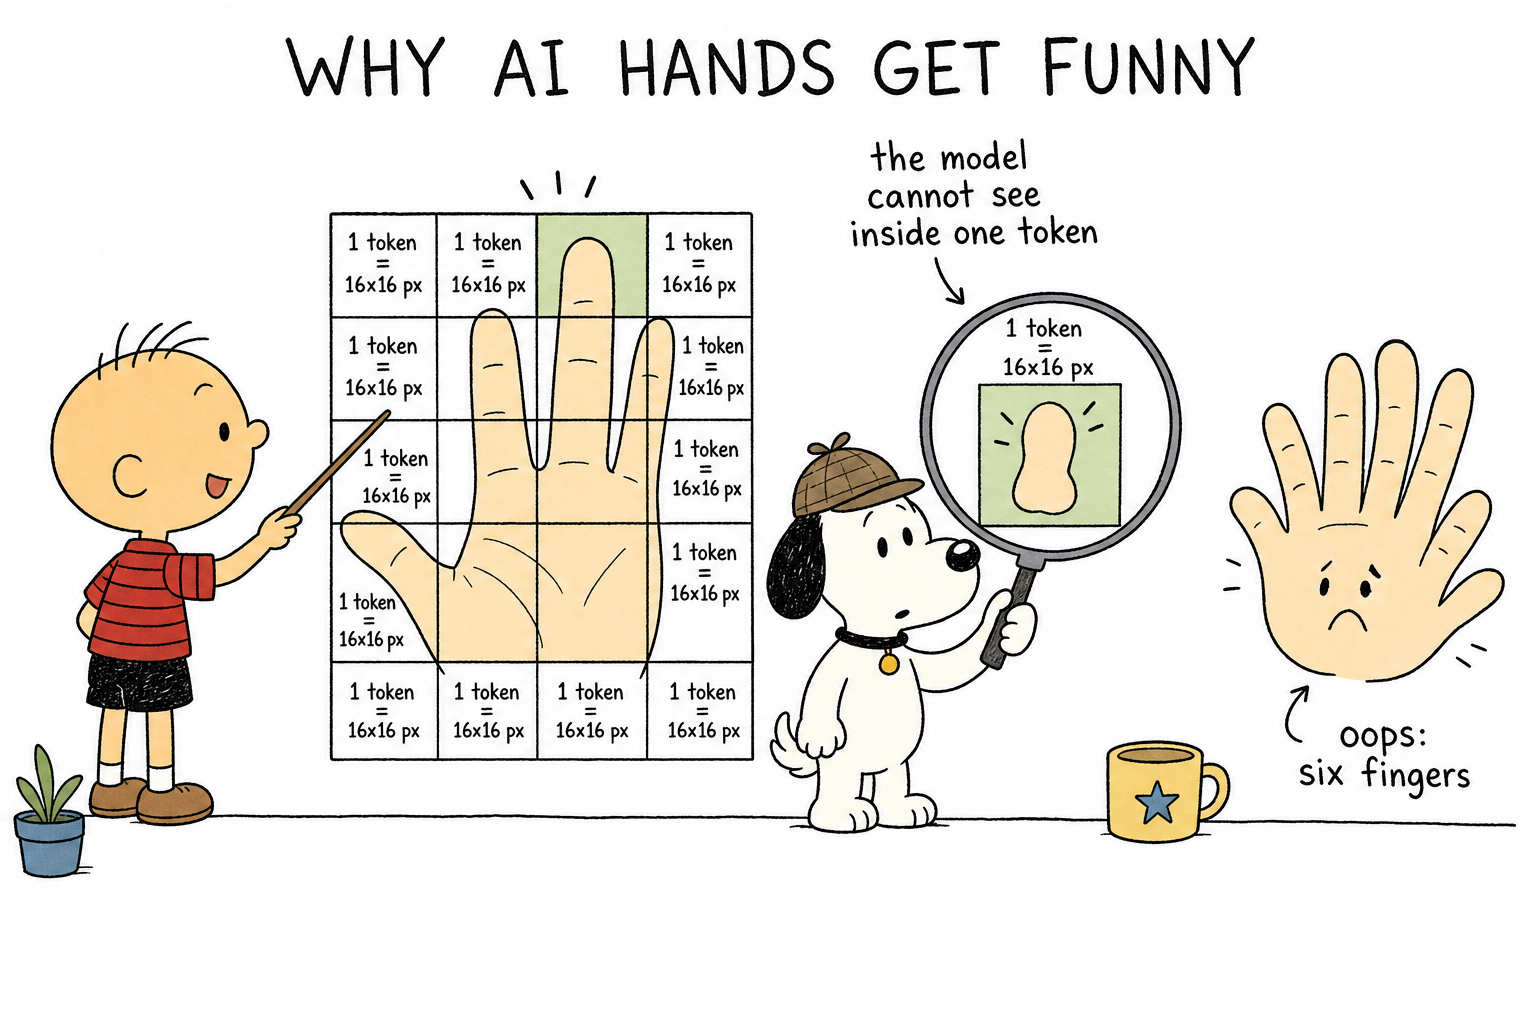
指、文字、細かな構造の崩壊。二段階の圧縮が共犯になった結果である。VAE は 8×8 ピクセルを 1 つの latent 位置に圧縮し、patchify はさらに 2×2 latent を 1 つの token にまとめる。つまり 1 token が 16×16 ピクセルを担当する。指の幅は十数ピクセル程度であることが多く、指一本まるごとが 1〜2 個の token に収まってしまう。attention がどれほど強くても、token 内部で 5 本の指の境界を見分けることはできない。文字はさらに厳しく、筆画はピクセル単位の構造だからだ。解決策は圧縮率を下げるか、解像度を上げるしかないが、どちらも計算資源の壁に正面からぶつかる。これは現世代アーキテクチャの構造的な短所であり、学習データのせいではない。
長尺動画の後半ドリフト。t2v は 81 フレームを一括生成し、フレーム間の一貫性は完全な 3D attention によって力ずくで保証されるため、5 秒以内なら問題になりにくい。より長い動画(s2v の分割自己回帰)は「前の区間の末尾数フレーム」によって状態を引き継ぐが、各区間の伝達は損失を伴う。誤差が区間ごとに蓄積し、人物の顔が少しずつ変わり、服の色も徐々にずれていく。これは LLM の長文におけるドリフトと同型であり、自己回帰の原罪である。
動きが小さい、カメラが退屈。複数の要因が同じ方向に圧をかけている。CFG は latent を「分類器が最も確信する」領域へ押しやるが、静的な構図は大きな動きより常に「安全」である。学習データでも穏やかなカメラワークが多数を占める。negative prompt にある「静的」「静止」といった語は、まさにこの傾向に対抗するためのものだ(デフォルトの negative prompt に「静止した画面」が入っていることからも、作者がこの問題に悩まされていたのは明らかである)。guide_scale を下げる、prompt にカメラモーションを明記する、といった操作は、いずれも動きに対する縛りを緩めるためのものだ。
物理的不整合(めり込み、奇妙な液体、勝手に揺れる影)。モデルが学んでいるのは「ピクセル統計上、次のフレームとして何がよく現れるか」であり、明示的な物理エンジンは一切持っていない。物理的な正しさは、学習データで密にカバーされている場面に限って創発する。データが薄い領域(複雑な遮蔽、流体、鏡面反射)ではすぐに破綻が露呈する。これは純粋なデータ駆動路線の既知の境界であり、業界が探索している world model の方向性は、まさにこの層を狙っている。
同じ prompt でも毎回出力が大きく異なる。生成の出発点はランダムノイズであり、prompt が制約するのは「終点がどの意味領域に落ちるか」だけである。その領域内部の具体的な見た目は seed によって決まる。これは bug ではなく特性だ。seed を固定して初めて制御された比較ができる。文末の実験がすべて seed 固定を要求している理由はここにある。
第十章 症状別ノブ対応表:調整の早見表
原理が一通り分かったところで、それを「出力が気に入らないとき、どこを回せばいいか」に翻訳する。各行の根拠は前章までにある。
| 症状 | 動かすべきノブ | 原理の出どころ |
|---|---|---|
| 画面構造が混乱する、物体が崩れる | --sample_shift を上げる、または --sample_steps を増やす | 第五章:構造は高ノイズ区間で決まる。shift は予算をそちらへ傾ける |
| 画面が硬い、動きの幅が小さい | --sample_guide_scale を下げる | 第五章:w が大きすぎると latent が自然分布から押し出され、まず動きが硬くなる |
| prompt にまったく合わない | --sample_guide_scale を上げる;prompt を細かく書く、または --use_prompt_extend を使う | 第五章 CFG + 第三章の拡写器 |
| 色が過飽和、細部が焦げてぼやける | --sample_guide_scale を下げる | 第五章:w が大きすぎる典型症状 |
| 細部はぼやけるが構造は合っている | --sample_shift を下げ、低ノイズ区間にステップを多めに残す | 第五章:細部は低ノイズ区間で磨かれる |
| 出力が遅すぎる | --sample_steps を減らす(品質と速度のトレードオフ);複数 GPU なら --ulysses_size を上げる | 第五章 80 回 forward の勘定 + 第八章 |
| OOM になる | --offload_model True --convert_model_dtype --t5_cpu の三点セット、または ti2v-5B に切り替える | 第六章の VRAM 勘定 + 第二章の二種類の VAE |
| 同じ動画を再現したい | --base_seed を固定する | ノイズは seed で決まる。同じ seed・同じ入力なら同じ出力になる |
| フレーム数で shape error が出る | --frame_num を 4n+1 にする | 第二章 VAE の圧縮規則 |
表の外にもう一つ注意点がある。--sample_shift を調整すると、二人の expert の作業量配分が静かに変わる。詳しくは第六章の連動する勘定を参照。
勘定を最後まで合わせる
冒頭のコマンドに戻ると、今では各段階に数字が付いている。
- prompt は umT5(5.7B) によって 4096 次元ベクトル ≤512 個に変換される。負の prompt も同じ処理を受ける
- ランダムノイズ latent: 16 × 21 × 90 × 160。
--base_seedで決まり、同じ seed なら再現できる - patchify され、5120 次元 token 75600 個になる
- 40 step の UniPC sampling。shift=12 によって 26 step が t≥875 の高ノイズ領域に押し込まれ、高ノイズ expert(14B) が担当し、残り 14 step は低ノイズ expert に交代する
- 各 step で 2 回 forward する(CFG。guide_scale は高ノイズ側 4.0、低ノイズ側 3.0)。全体で 14B 推論 80 回、attention の計算量は 10¹⁷ FLOPs オーダー
- latent は因果畳み込み VAE によってストリーミング decode され、81 フレームの 720p に戻り、libx264 で encode されて保存される
時間の大半は中央の 14B forward 80 回で、全体の九割以上を占める。T5 と VAE はそれぞれ一回しか走らない。だから高速化の手段はすべて sampling loop に向かう。step 数を減らす、CFG を減らす(蒸留)、複数 GPU で attention を分割する。T5 や VAE を必死に最適化する人がいないのは、勘定がそこにないからだ。
このシステムに魔法はない。あるのは四つのものの組み合わせだけだ。圧縮器(VAE)、圧縮空間で速度場を学ぶ大きなネットワーク(DiT)、速くて安定した数値積分(flow matching + UniPC + shift)、意味を押し込む条件付け機構(cross-attention + CFG + 各タスクの注入)。骨格は 2024 年以降の業界の公約数であり、別の動画モデル(Kling、Sora、Veo)を読むときも、部品は違っても締め方は似ている。各社の本当の堀はデータ配合にあり、そこはちょうどオープンソースリポジトリからは見えない部分である。
全文から三文だけ持ち帰るなら、この三つだ。
- 生成はサムネイル上で起きている: 動画はまず VAE で 46 倍小さくされ、大モデルは最初から最後まで圧縮表現だけを触り、最後の一歩で初めて pixel に拡大される。
- denoising は 40 回道を尋ねる直線ナビゲーションである: モデルは毎回一つの方向を返す(しかも正負をそれぞれ一回ずつ尋ねて差を取る。これが CFG)。scheduler はその方向に一歩動かす。前 26 step で構造を決め、後 14 step で細部を磨き、二人の expert は 875 目盛りで引き継ぐ。
- すべての engineering 上の難題は一つの数字に由来する: 75600 個 token の二乗級 attention。VRAM、速度、複数 GPU 構成は、すべてこれと格闘している。
次に何を読み、何を手を動かして試すか
論文はこの流れで読むとよい。各論文は本文の一〜二章に対応している。
| 論文 | 本文での対応 | 一言でいうと |
|---|---|---|
| DDPM(Ho et al., 2020) | 第一章前半 | 拡散生成の基礎フレームワーク |
| Flow Matching(Lipman et al., 2022)/ Rectified Flow(Liu et al., 2022) | 第一章 | ランダムな曲線を直線に引き伸ばす |
| Latent Diffusion(Rombach et al., 2021) | 第二章 | なぜ圧縮空間で生成するのか |
| DiT(Peebles & Xie, 2022) | 第四章 | transformer 拡散 backbone と AdaLN |
| Classifier-Free Guidance(Ho & Salimans, 2022) | 第五章 | 二回の forward の差分が分類器勾配そのもの |
| Wan 技術レポート(arXiv:2503.20314) | 全体 | これらをどう動画モデルとして組み立てるか |
手を動かす道筋のほうが、論文より速く勘所を作れる。おすすめはこの順番だ。
- ti2v-5B を consumer GPU で demo まで通し、
--base_seedを固定する --sample_shiftだけを変える(たとえば 3 / 5 / 12 をそれぞれ回す)。同じ seed で比較し、「構造 vs 細部」の予算配分がどう動くかを目で見る--sample_guide_scaleだけを変える(1 / 3 / 7)。prompt への貼り付きと過飽和がトレードオフになる様子を見るtext2video.pyの sampling loop に breakpoint を置き、各 step でt.item()、latents[0].std().item()、現在の expert を出力する。第五・六章の表と照らし合わせ、26/14 の配分を自分の手で再現する- 16 channel の latent から任意の 3 channel を RGB として描画し、「動画の幽霊」が少しずつ姿を現すのを見る——「拡散は latent 空間で構造を彫り、VAE が細部を補う」という標語を直感に変える
image2video.pyの mask 構築を読み、第七章と照らし合わせる。そのうえで自問する。もし「与えられた最初と最後の二フレームから中間を生成する」タスクをやるなら、mask はどう変えるべきか? 業界ではこのタスクを FLF2V と呼び、Wan2.1 はこの variant を公開しているので、その実装を答え合わせに使える
engineering 実装では、このコードにはまだ文書と噛み合っていない落とし穴がかなりある。踩坑リストは別記事の読完 Wan2.2 全部源码之后にまとめてある。原理と落とし穴は、合わせて読むとちょうどよい。
 WeChat Pay
 Alipay
コメント
コメントは即時公開されますが、ポリシー違反時は非表示になる場合があります。