Wan2.2 リポジトリを generate.py からスケジューラまで読み進めたあと、ほんとうに書き残す価値があるのは「このモデルをどう使うか」ではなく、このコードがあなたの気づかないところでどう噛みついてくるかだ。
Wan2.2 は Alibaba の Wan チームがオープンソース公開した動画生成モデルライブラリで、generate.py という1つの入口から、--task によって5つの推論パイプラインへ分岐する。テキストから動画、画像から動画、テキスト・画像統一から動画、音声から動画、キャラクターアニメーションだ。表面上は「1つのモデル、5つの遊び方」に見えるが、コードを開くと、むしろ5つの並行世界が、CLI という薄い層で貼り合わされているように見える。以下ではコードを読んだ順番に沿って一通り見ていき、落とし穴はその場で印をつけ、重要なところはそのままソースコードを貼る。
この記事で扱うのは工学上の落とし穴だ。まず動画生成そのものの原理、つまり VAE 圧縮、flow matching、CFG、MoE 二重専門家の数学と数値を理解したいなら、姉妹編のWan2.2 のソースコードで学ぶ動画生成を読んでほしい。2本を合わせて読むとよい。
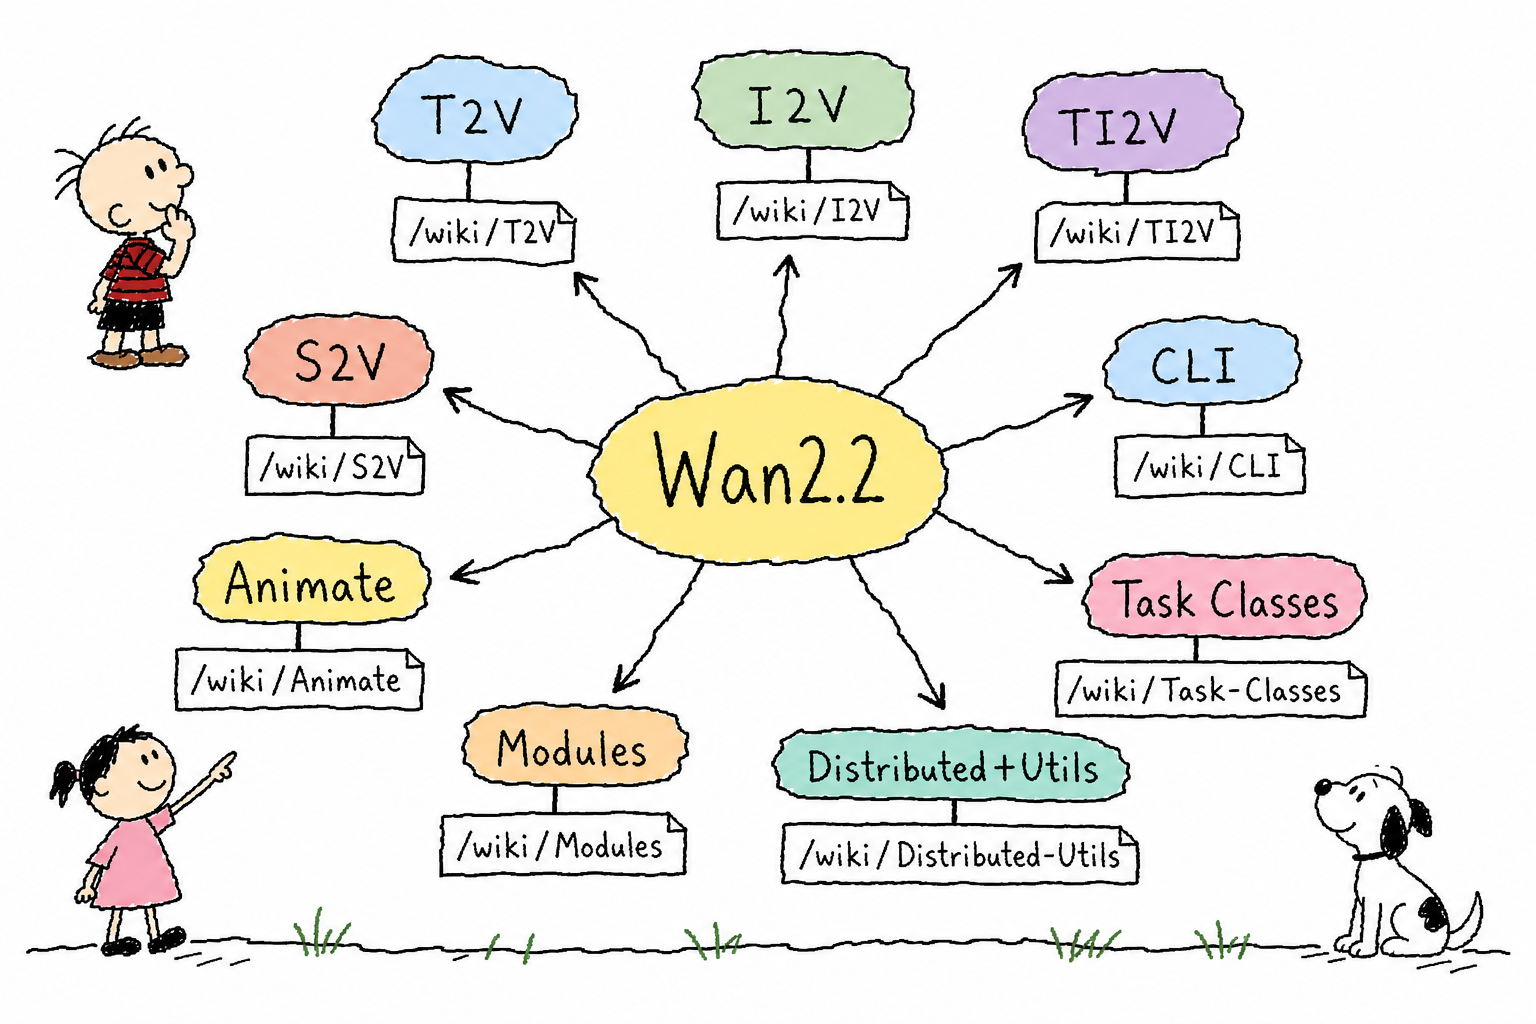
5つのタスク、5通りの入力、5通りの落とし穴
Wan2.2 はタスクの行列だ。t2v-A14B、i2v-A14B、ti2v-5B、s2v-14B、animate-14B は、それぞれ要求する素材がまったく違う。純粋なテキスト、参照画像、参照画像に音声を加えたもの、さらには動画1本と前処理で生成した姿勢素材パッケージまである。どのタスクを使うのか、どんな入力を用意するのか、その答えは generate.py の引数検証コードにある。ドキュメントには半分しか書かれていない。
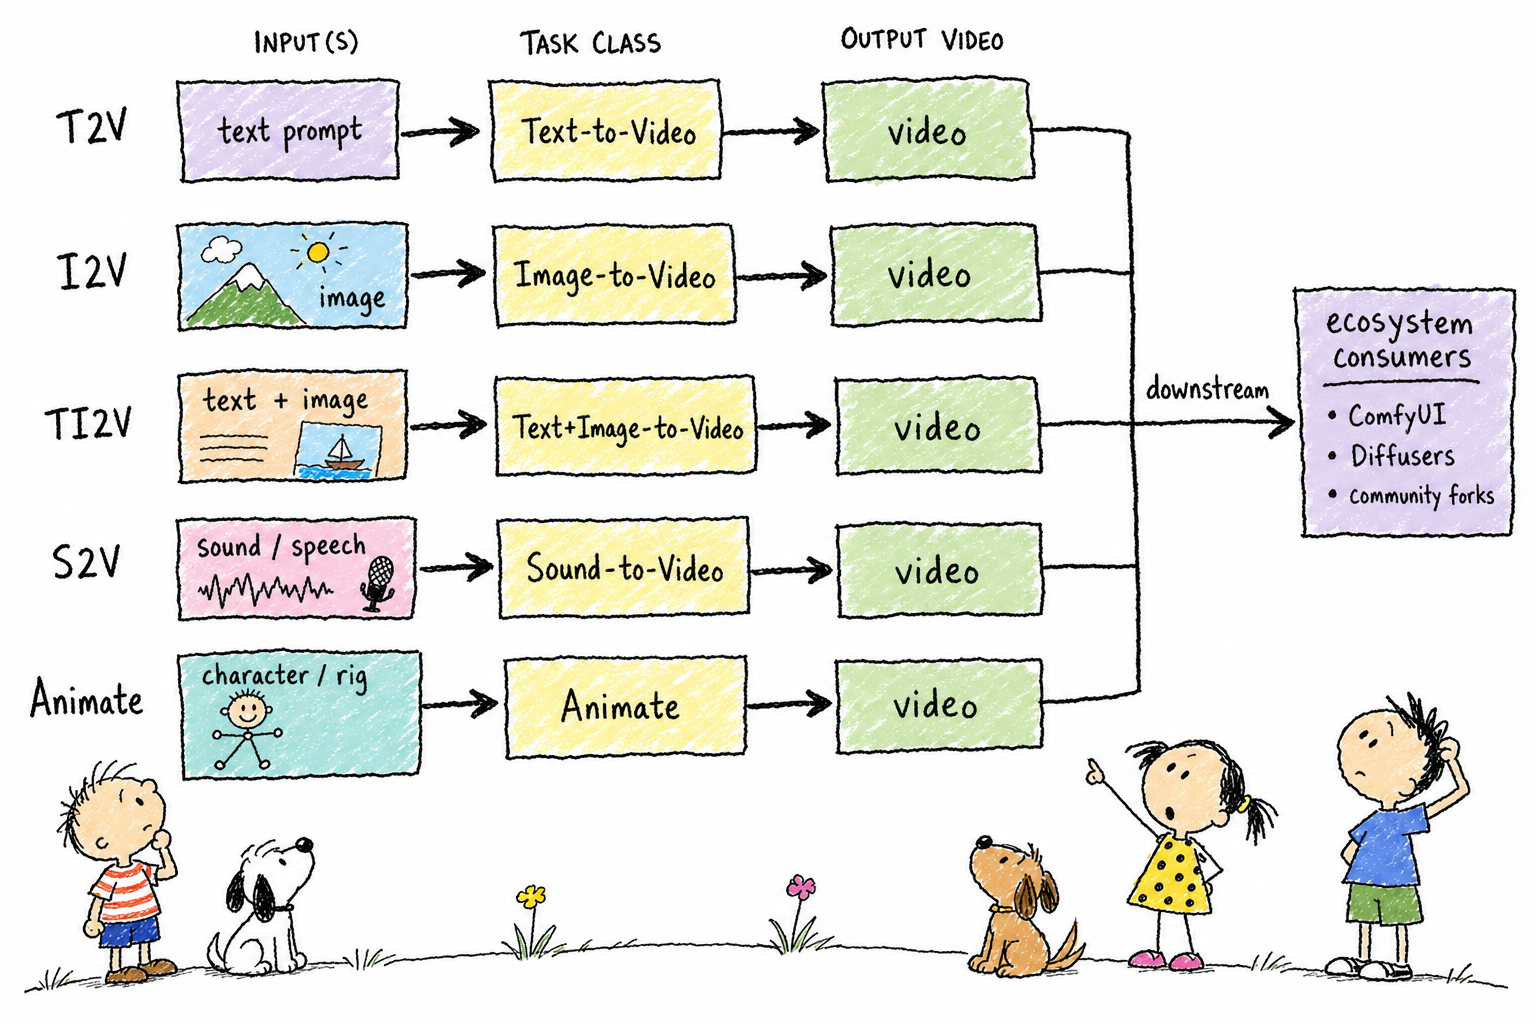
まず generate.py にあるデフォルト値のフォールバック処理を見てみよう。
if args.prompt is None:
    args.prompt = EXAMPLE_PROMPT[args.task]["prompt"]
if args.image is None and "image" in EXAMPLE_PROMPT[args.task]:
    args.image = EXAMPLE_PROMPT[args.task]["image"]
--prompt を渡さなくても、コードはエラーを出さない。ハードコードされた例文、サングラスをかけた白猫がサーフィンする内容を黙って適用する。s2v-14B と i2v-A14B は、さらに同じ例を共有している。prompt を渡さずにこの2つのタスクをそれぞれ走らせると、出てくるものの雰囲気が同じになる。どちらのタスクも公式 demo 素材を使って空回ししているからだ。--image、--audio、--tts_* にも似たようなフォールバックがある。初心者は初回に demo が通ったあと、自分の設定が効いていると勘違いしがちで、これが最大の誤解源だ。
--size の意味はタスクごとに一致しない。t2v/ti2v では解像度だが、i2v/s2v では実際には目標の画素面積で、最終画面の縦横比は入力画像に追従する。1280*720 と入れても、出力がそのサイズになるとは限らない。frame_num は 4n+1 を満たす必要がある。3つのタスクでデフォルト値もそれぞれ違う(t2v/i2v は 81、ti2v-5B は 121、animate-14B は 77)。背後には VAE の時系列圧縮率の違いがあり、この数字は気軽に変えてはいけない。Wan-Animate は2段階の流れだ。まず独立した preprocess_data.py を実行して pose/mask/reference 素材パッケージを作り、それからこのディレクトリを generate.py に渡す。前処理を飛ばして、元の動画パスをそのまま渡して走らせるのが、このコードで最もよくある失敗パターンだ。
5層アーキテクチャ、何が何に貼りつくのか
wan/ パッケージを分解すると、configs はどの重み・どの形状でモデルを走らせるかを決める。modules は純粋なネットワーク定義で、「タスク」という概念を知らない。distributed は pipeline 用の並列ツールボックス。utils はサンプリング数学と雑多なもの。それらを貼り合わせているのが、text2video.py、image2video.py などの pipeline クラスだ。
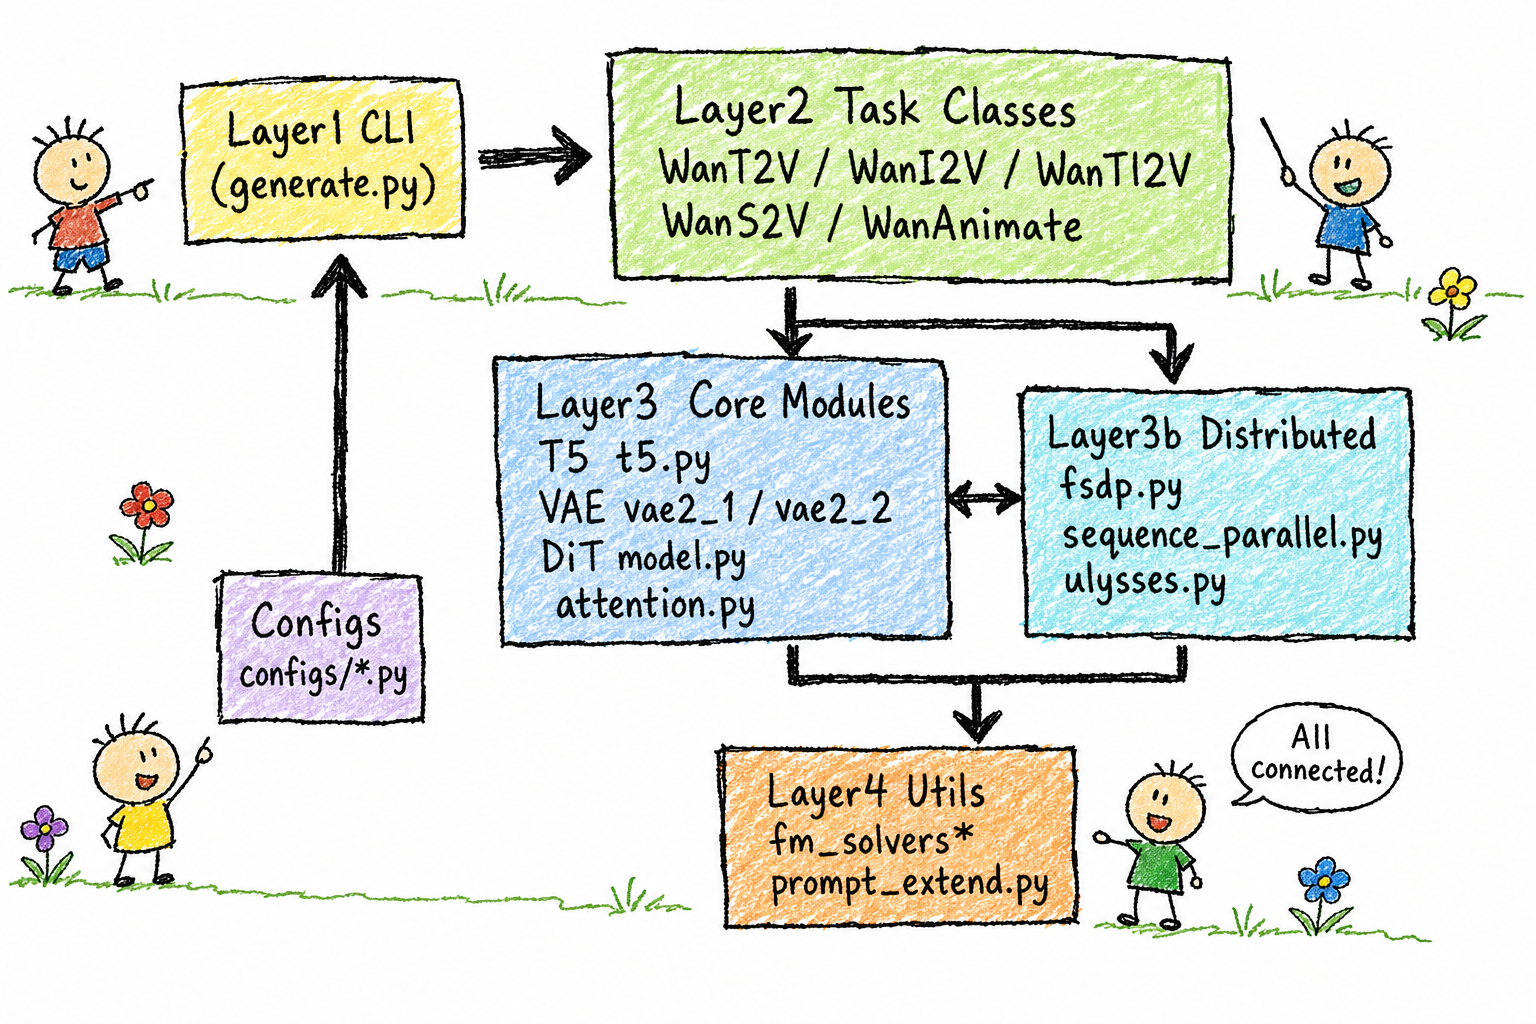
この層には、いくつか歴史的な負債が残っている。wan/distributed/__init__.py は空ファイルで、すべての pipeline はそこを迂回して子モジュールから直接 import しており、パッケージ名は namespace の場所取りとしての役割しか残っていない。wan/utils/__init__.py の __all__ には HuggingfaceTokenizer と書かれているが、このクラスは実際には wan/modules/tokenizers.py から export されているため、__all__ に従って from wan.utils import HuggingfaceTokenizer と書くと、そのまま ImportError になる。期限切れの宣言が片付けられずに残っているわけだ。
さらに import wan という1行の代償もある。これは5つの pipeline とそれぞれの依存を一気に起動する。t2v-A14B だけを走らせたい場合でも、speech2video.py の TTS/CosyVoice の重い依存まで連れてくる。どれか1つのタスクモジュールの import が失敗すると、無関係な4つのタスクまで巻き添えで落ちる。
一次生成では何が通り、どの段階でこっそり失敗するのか
t2v-A14B(MoE 双専門家)を主線にすると、generate.py が引数を解析 → pipeline クラスを選択 → テキスト符号化 → 拡散サンプリング → VAE デコード → mp4 として保存、という流れになる。
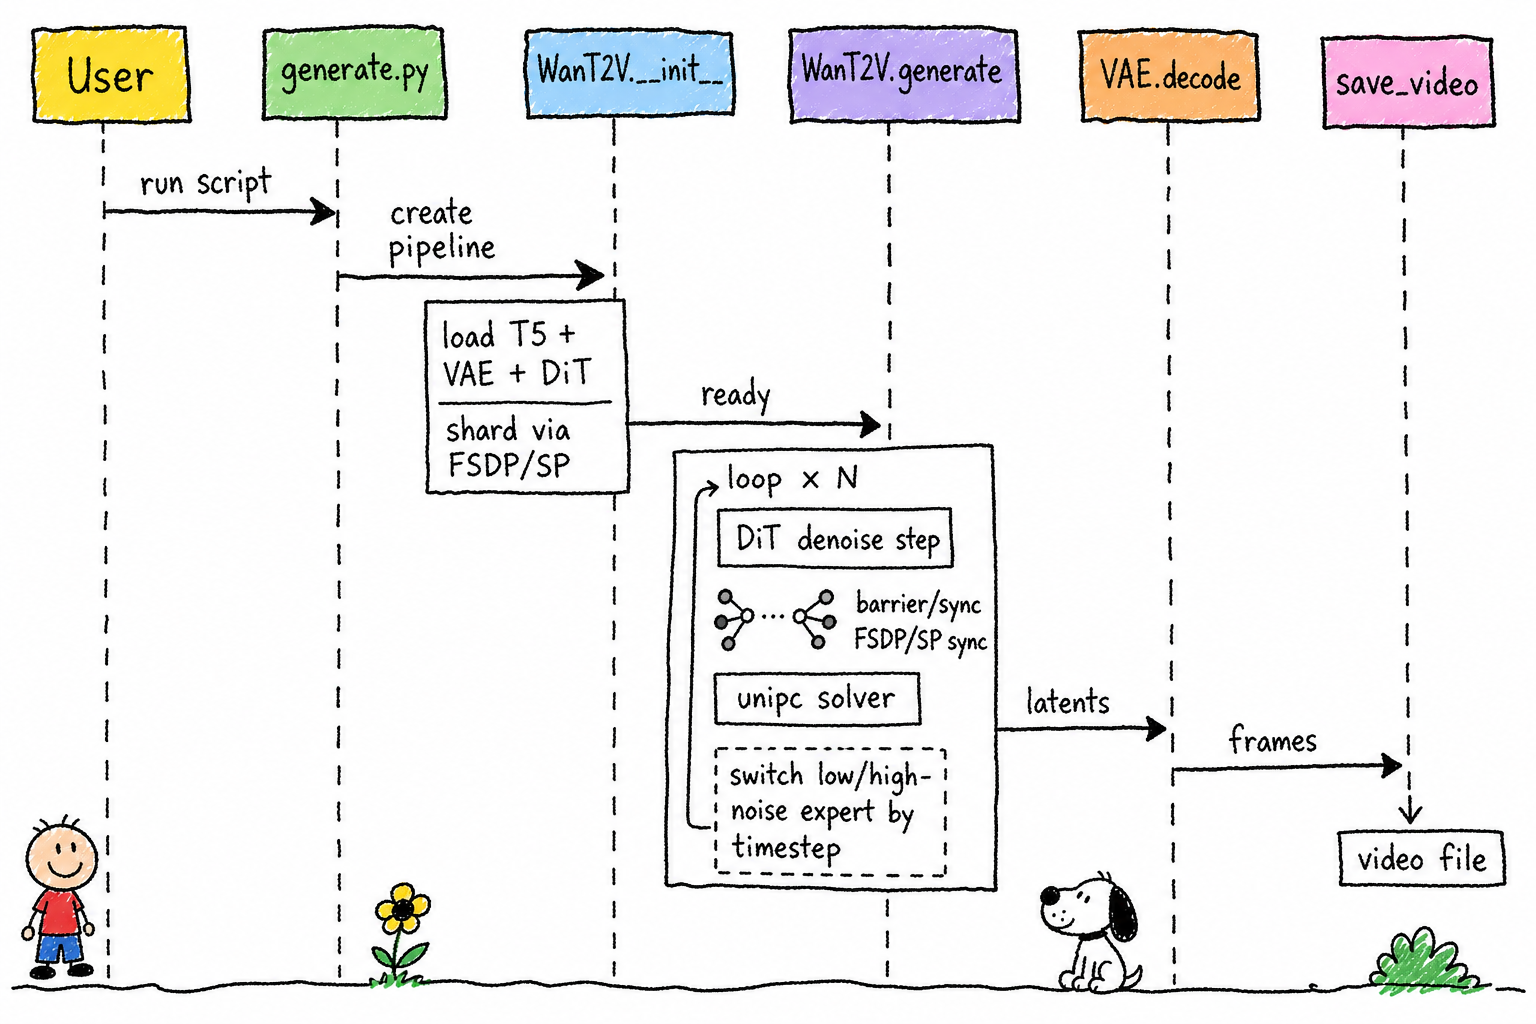
引数チェックの粒度は均一ではない。i2v-A14B は --image を渡し忘れるとそのまま assert で落ちる。s2v-14B の --audio 不足、animate-14B の video/pose/mask 不足には対応する断言がなく、エラーは実行時まで引き延ばされてから露呈する。ドキュメントには frame_num が 4n+1 を満たす必要があると書かれているが、コードにはその assert がない。誤ったフレーム数を渡すと、DiT/VAE 内部で形状が合わなくなってから爆発し、エラー位置は原因からかなり遠い。
サンプリングの主ループで誤解されやすい点がある。CFG(条件あり + 無条件で DiT をそれぞれ1回ずつ走らせる)に MoE 双専門家の切り替えが重なると、各 timestep は「専門家を1つ選び、前向き計算を2回走らせる」になる。2つの専門家が同じステップに登場することはない。切り替えの根拠は t.item() >= boundary * num_train_timesteps で、スケジューラが吐いた timestep の値をそのまま比較している。この両者は独立に維持される状態だ。スケジューラを替えたり、shift が変わって timestep の値域がずれたりすると、専門家の切り替え位置もつられて偏る。エラーは出ず、品質低下を目視で見るしかない。
次に落とし込みを見る。wan/utils/utils.py の save_video の末尾はこうだ。
        # write video
        writer = imageio.get_writer(
            cache_file, fps=fps, codec='libx264', quality=8)
        for frame in tensor.numpy():
            writer.append_data(frame)
        writer.close()
    except Exception as e:
        logging.info(f'save_video failed, error: {e}')
エンコードに失敗しても logging.info を1行出すだけで、raise しない。主処理は保存に失敗したことを知らないまま、merge_video_audio へ進み、ログの最後には Finished と出るが、ディスクには mp4 がない。merge_video_audio で ffmpeg が落ちた場合も同じく握りつぶされる。前段の処理がすべて正しくても、最後の一歩で死に、しかも黙ったままだ。
五つの平行世界
5つのタスククラスは互いに基底クラスを共有していない。_configure_model という共通の骨格が5つのファイルにそれぞれコピペされている: eval + 勾配凍結 → 系列並列のとき attention にモンキーパッチ → dist.barrier() → FSDP 分割または GPU へ移動。
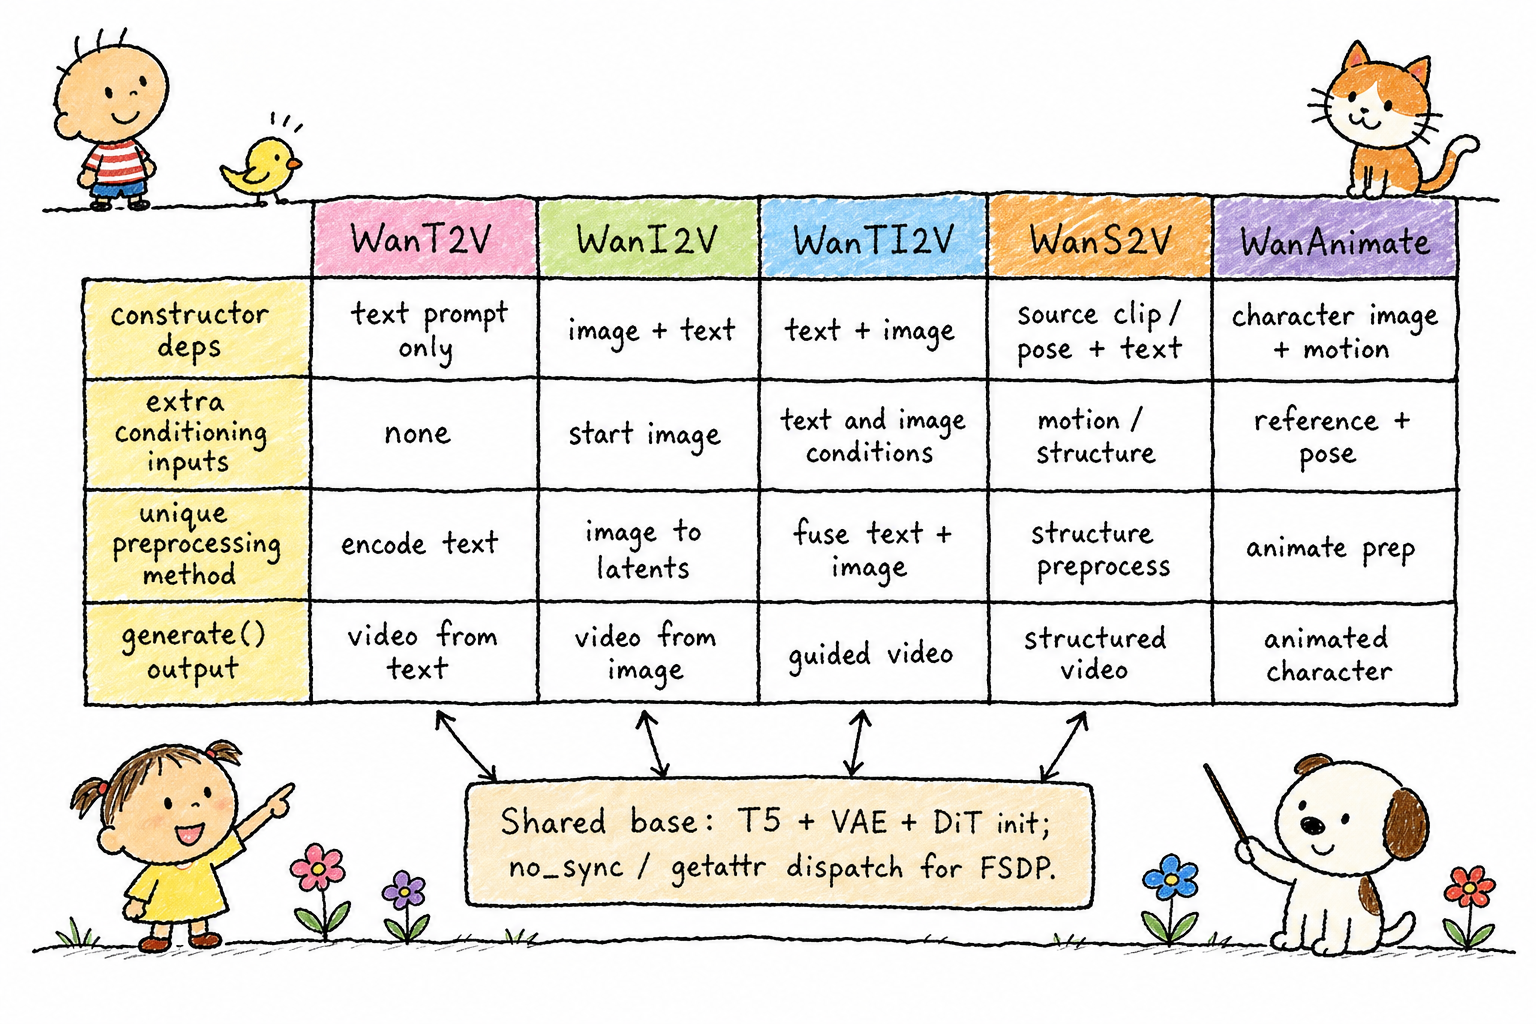
5つもコピペすれば、細部はすでにズレている。S2V と Animate のバージョンには model.use_context_parallel = True が1行多く、ほかの3つにはない。意図的なのか漏れなのか判断しづらい。CFG のデフォルト開閉も統一されていない: 4つのタスクはデフォルトでオン、Animate はデフォルトでオフ(guide_scale=1 は CFG を実行しないのと同じ)。調整を比較するときに「Animate のほうが速い」を bug として調査すると、徒労に終わる。それは意図的に計算量を節約する設計で、docstring の「表情制御のみに使い、ほとんどの場合不要」という一文が理由を説明しているが、コードはそこを読みに行けとは教えてくれない。
TI2V は本質的にはディスパッチャだ: 画像を渡すと内部の i2v 分岐へ、渡さないと t2v へ進み、1つのモデルを共有する。ここにはデフォルト値の罠がある: WanTI2V.generate() のシグネチャでは frame_num=81 なのに、転送先の t2v()/i2v() のシグネチャでは frame_num=121。このクラスをそのまま Python ライブラリとして使い、フレーム数を明示しないと、出てくるのは81フレームになる。CLI ユーザーはここを踏まない。generate.py が必ず設定の121を明示的に渡し、このデフォルト値を迂回するからだ。
S2V は唯一、自己回帰分段するタスクで、音声長から num_repeat を計算し、ループで断片を生成し、前の断片の末尾 latent で接続する。get_gen_size には「前回の生成結果を続けて書く」ためのインターフェイス(pre_video_path 引数)が残っているが、主フローが呼ぶときは常に None を渡す。インターフェイスは書かれているが、道は通っていない。コードを読むと、その能力を過大評価しやすい。
優雅な降級を書いたが、誰も使っていない
DiT 主幹(WanModel)は、反復する Attention Block の積み重ねでできている。RoPE 付き Self-Attention、テキスト context に接続する Cross-Attention、FFN、そして AdaLN の六路変調で駆動する。
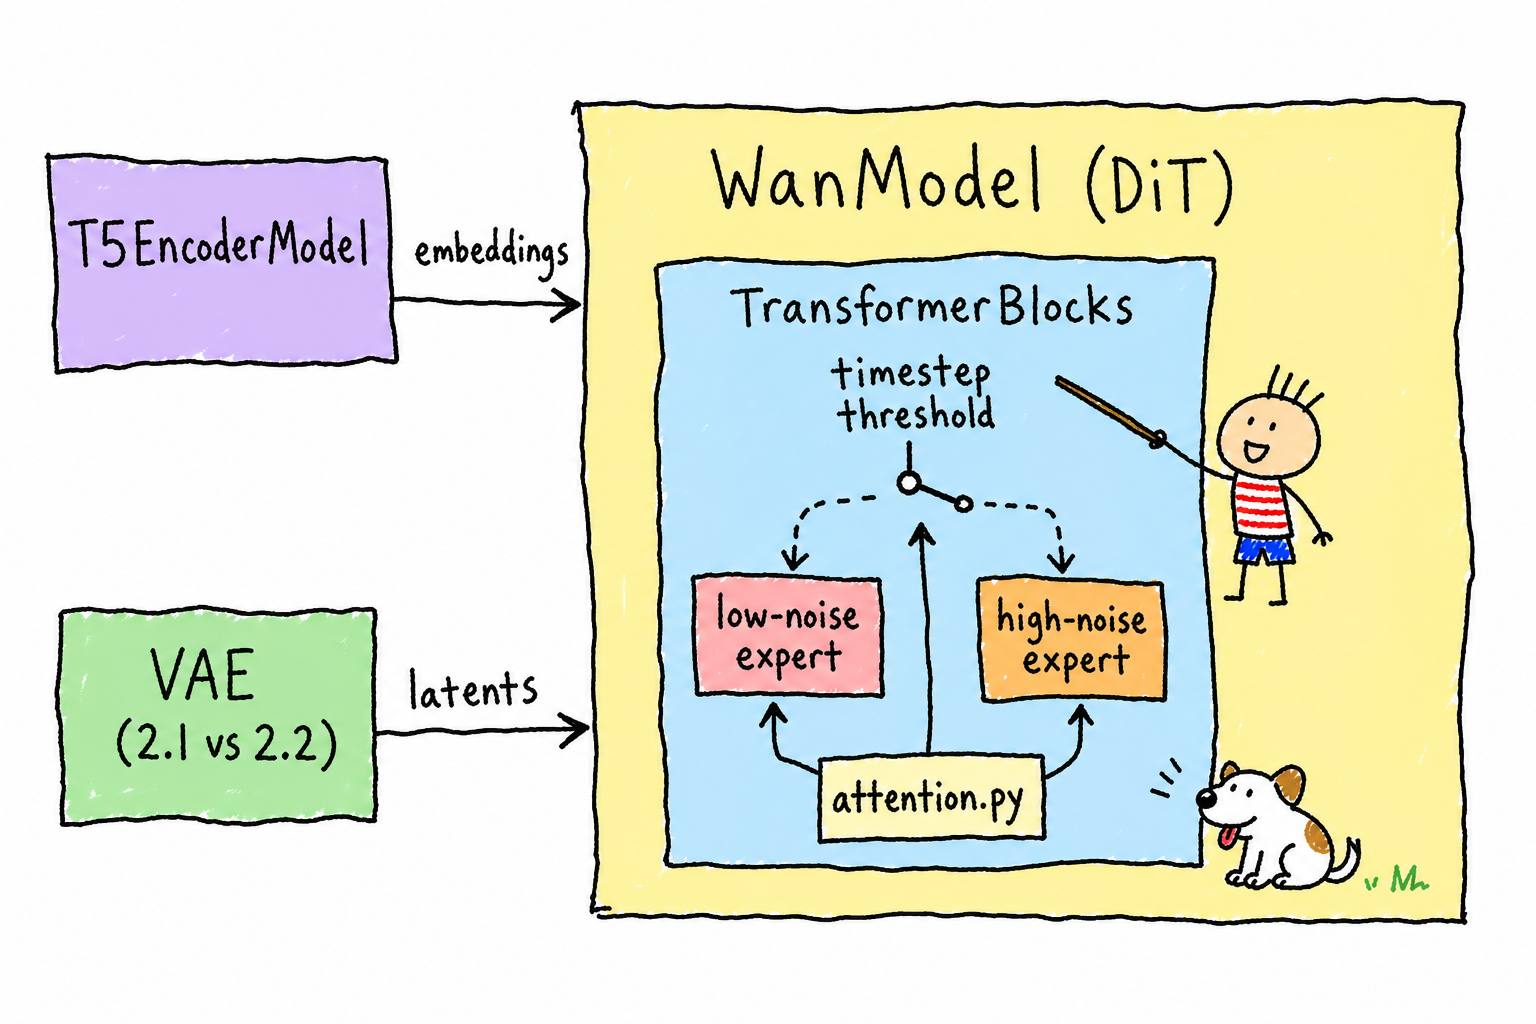
wan/modules/attention.py には、兜底つきの分配関数 attention() がある。FlashAttention が入っていれば転送し、入っていなければ PyTorch の scaled_dot_product_attention に退避する。だが model.py の 9 行はこう導入している。
from .attention import flash_attention
主幹は最下層の flash_attention() を直接呼んでおり、その内部では flash-attn が入っていない場合、assert FLASH_ATTN_2_AVAILABLE(attention.py:112)を硬く実行して、そのまま崩れる。兜底は書かれているが、主幹は使っていない。attention カーネルはさらに q.device.type == 'cuda' も要求するため、CPU や Mac の MPS では初回呼び出しで assert に失敗し、案内もない。
VAE の落とし穴はもう一層深く隠れている。Wan2.1 版(16 チャンネル)と Wan2.2 版(48 チャンネル、patchify と双経路ダウンサンプリングが追加)は構造が相互に非互換で、2 系統の正規化 scale は次元が異なる。checkpoint と VAE 版を取り違えると、出る誤りはただの tensor shape mismatch で、根因は見えない。Wan2.2 VAE の encode/decode はさらに try/except TypeError で不正な入力を兜底し、型を間違えて渡すと例外を飲み込み、ログを出して None を返す。呼び出し側はずっと離れた場所でようやく None のせいで爆発する。Wan2.1 版にはこの try/except がない。同じリポジトリで、2 版の VAE は容錯の気性が違う。
T5 側では、umT5 は層ごとに独立した相対位置エンコーディングを使い、24 層それぞれが bias を計算する。設定では shared_pos=False で、bug ではなく umT5 の設計だが、この設定行を見ないと共有だと思いやすい。より実際的な危険は、t5.py と 2 版の VAE が checkpoint の読み込みにすべて裸の torch.load を使っており、weights_only=True を付けていないことだ。出所の分からない重みファイルを読み込むとき、逆シリアライズで任意コードが実行される危険がある。
VRAM と計算力をどう分けるか
複数 GPU 戦略には 2 つの軸がある。FSDP は VRAM を担当し(パラメータの shard)、Ulysses の系列並列は計算力を担当する(activation の系列次元を別々のカードに切る)。どちらも torch.distributed の大域 world を使い、独立した data parallel 次元はない。1 回の起動で使うすべての GPU は、すべて同じ並列グループに属するか、そうでなければ単一カードになる。
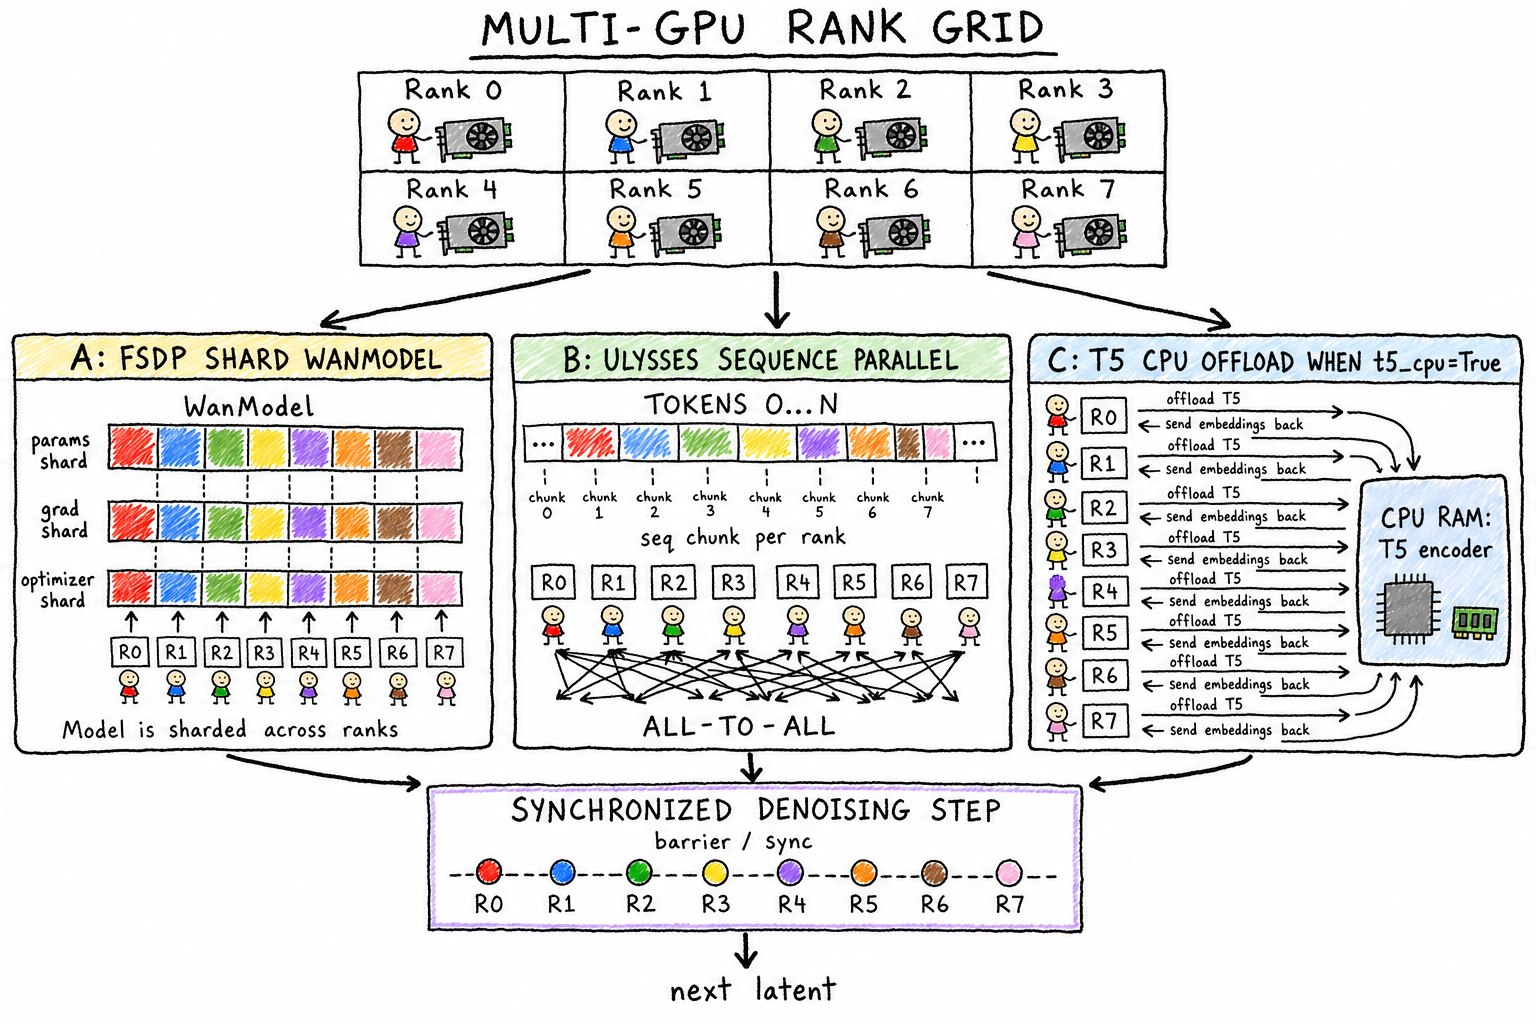
Ulysses の考え方は 2 回の変換だ。q/k/v を heads 次元に沿って scatter し、系列次元に沿って gather する。すると各カードは完全な系列を持って heads の一部を計算し、ローカルで FlashAttention を走らせたあと、all-to-all で元に戻す。この中には等長という仮定が埋まっている。sp_dit_forward は torch.chunk で系列を切り、pad_freqs は「各カードの切片が同じ長さ」という前提で位置エンコーディングを計算する。torch.chunk では割り切れないと最後の 1 塊がより短くなる。系列長が ulysses_size の整数倍でないと、RoPE 周波数と token が対応しなくなり、静かに誤って、品質低下としてしか表れない。
FSDP の省 VRAMの恩恵も、最初から得られるわけではない。モデルはいったん丸ごと GPU に載せられ、そのあと shard_model に渡されて shard される。meta device 初期化は通っていない。shard の前に、各カードがまず完全なモデルを載せられなければならず、VRAMのきついカードは起動した瞬間に OOM になる。また free_model は FSDP の private 属性 _handle.flat_param.data に触っており、torch のアップグレード後にはこの行がいつ壊れてもおかしくない。
shift 引数が二回、二つの場所で効いている
スケジューラ(FlowUniPCMultistepScheduler / FlowDPMSolverMultistepScheduler)は、diffusers のスケジューラを flow-matching 版に改造したもので、ファイル冒頭には "Copied from diffusers" と書かれている。
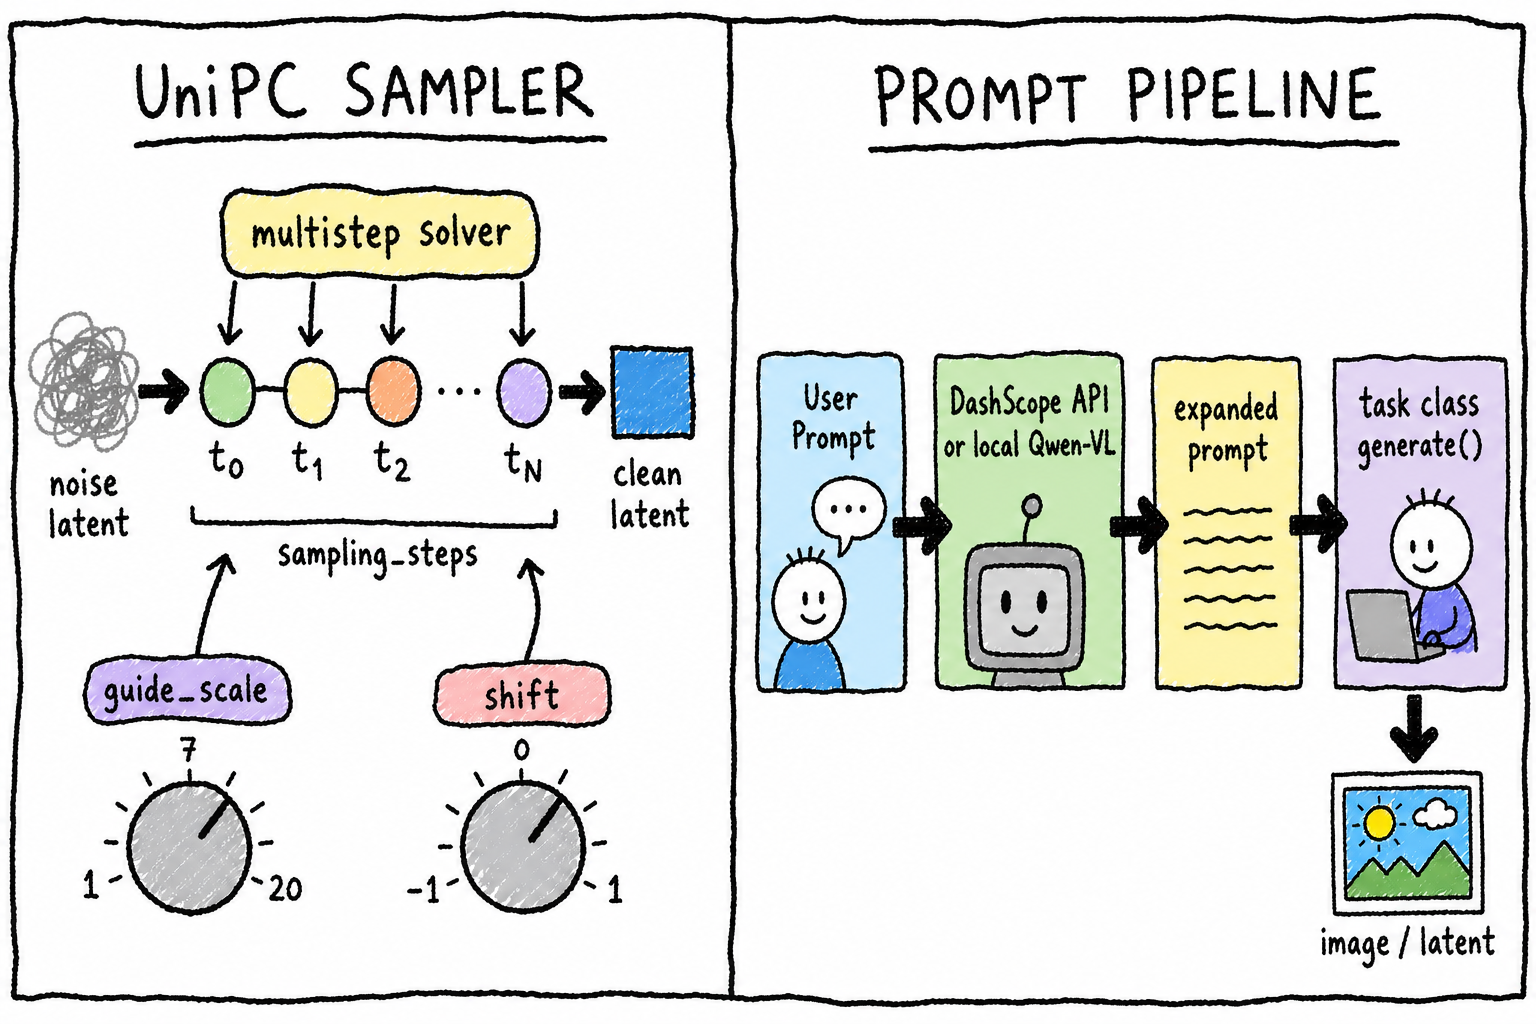
text2video.py で UniPC を構築するコード:
sample_scheduler = FlowUniPCMultistepScheduler(
    num_train_timesteps=self.num_train_timesteps,
    shift=1,
    use_dynamic_shifting=False)
sample_scheduler.set_timesteps(
    sampling_steps, device=self.device, shift=shift)
コンストラクタの shift=1 は固定値で、本当の --sample_shift は set_timesteps の中で効く。DPM++ 側はまた経路が違う。呼び出す前に get_sampling_sigmas(steps, shift) で sigma 列を手計算してから渡す。shift のデフォルト値を調整したり、第三の solver を追加したりしたいとき、片方を真似して書くともう片方を漏らしやすい。字面どおりにコンストラクタ引数を変えても、効果はない。
Prompt 拡写には二つのバックエンド、DashScope オンライン API とローカル Qwen があり、rank 0 で一度だけ実行してからブロードキャストし、複数カードでの重複呼び出しを避けている。ローカル Qwen は呼び出しのたびにモデル全体を CPU↔GPU 間で往復させる。メインモデルの显存を空けるためのトレードオフだが、その代償として毎回の拡写に目立つ遅延がある。DEFAULT_SYS_PROMPTS 辞書は三つのタスクでネスト構造がそれぞれ異なり、decide_system_prompt は文字列マッチの固定ブランチに頼っている。新しいタスクを追加するには新たなブランチを手書きする必要があり、ネストを書き間違えると実行時に KeyError になる。
三つの解像度テーブル
設定レイヤー最大の命名トラップ: t5_checkpoint/vae_checkpoint が組み立てるのはファイルパスだが、low_noise_checkpoint/high_noise_checkpoint は from_pretrained に渡す subfolder のサブディレクトリ名だ。同じ xxx_checkpoint という命名で、用途は二つ。モデルディレクトリを手動で整理したり、サブディレクトリ名を変えたりすると、エラーは transformers レイヤーの「config.json が見つからない」になり、フィールドを間違えたとは教えてくれない。
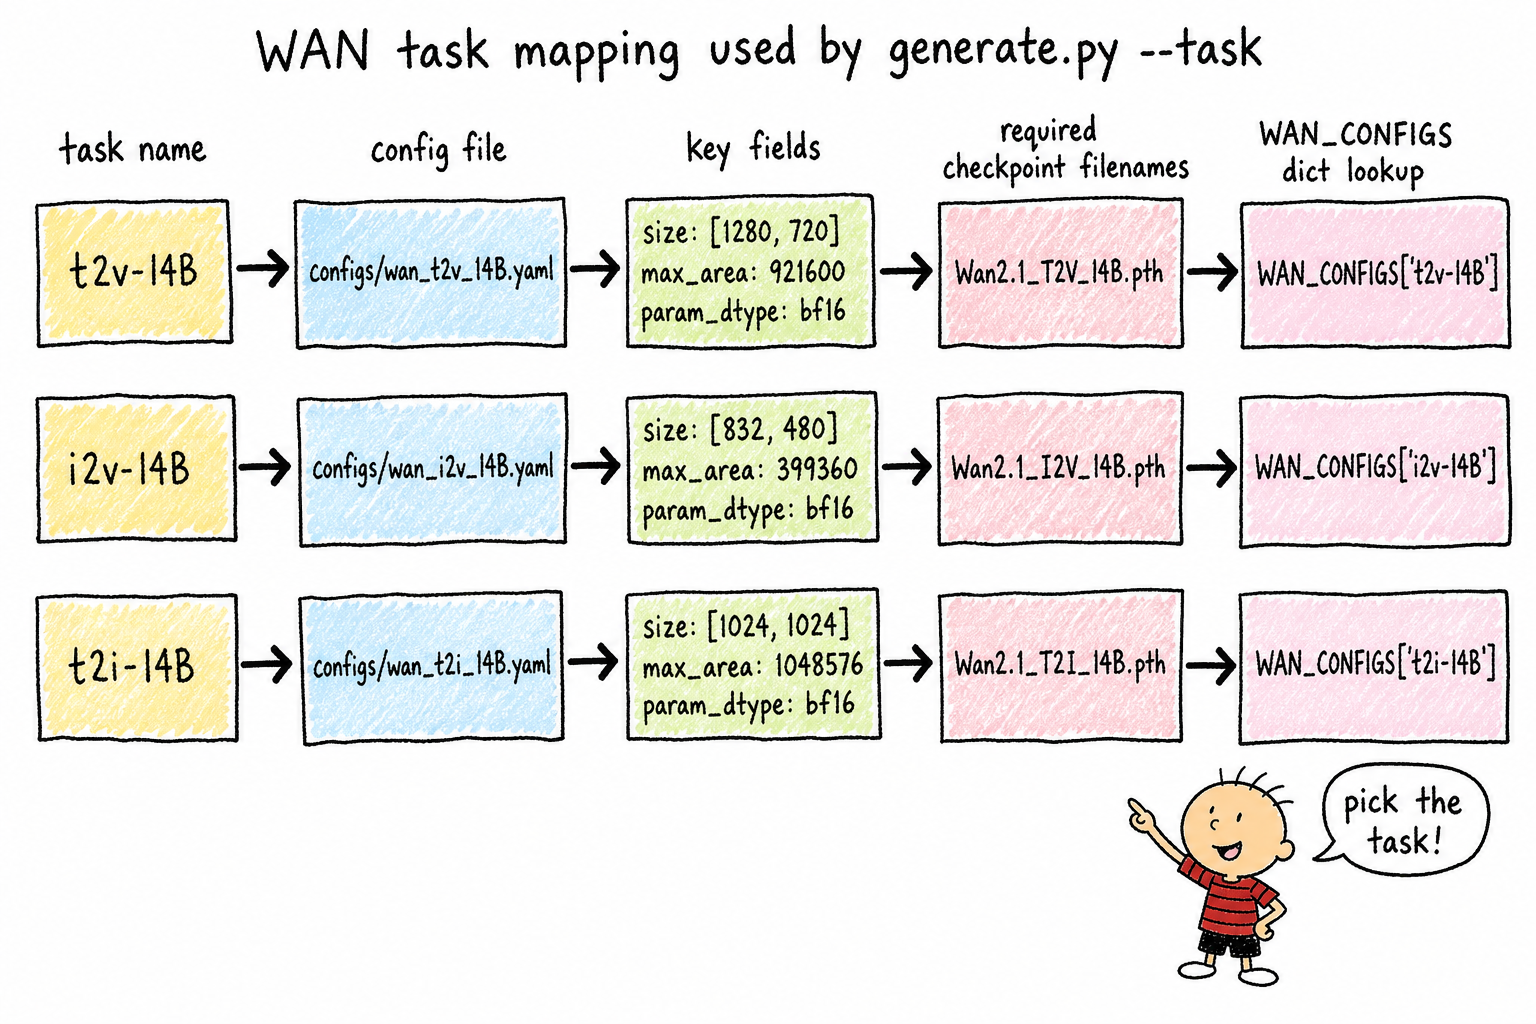
解像度のホワイトリストは SIZE_CONFIGS、MAX_AREA_CONFIGS、SUPPORTED_SIZES という三つの独立保守テーブルに分かれている。ti2v-5B は 704*1280 を使い、ほかのタスクでは 720*1280 がよく使われる。この二つの数字は見た目がかなり似ていて、README やコミュニティの投稿でもよく混同される。渡し間違えても「解像度はサポートされていません」とは出ず、三つのテーブルで key が見つからないというエラーになる。新しい解像度を追加するには三つのテーブルを同時に変える必要があり、一つでも漏れても静的チェックは何も警告してくれない。
共通するパターン
九つの分析を並べてみると、パターンが浮かび上がる。このコードの落とし穴の多くはロジックエラーではなく、安全なフォールバックは書かれているのに、主経路で使われていないことだ。attention() の降格、_validate_args のばらついたアサーション、frame_num のドキュメント要件とコード検証のずれ、shift の二つの有効化ルートは、すべて同じパターンの変種だ。ドキュメント、デフォルト値、実際のコードパスの三者が切り離され、チェーンの深いところへ進むほど、代償は見えにくくなる。CLI のエラーが、ランタイムエラーへ劣化し、さらにエラーは出ないが品質だけがこっそり悪くなる状態へ劣化していく。
このコードを引き継いで二次開発するなら、効く経験則は一つ。docstring やフィールド名の字面を信じず、コードの中で実際に効いているパスを信じること。同じフィールド、同じ関数でもタスクによって意味が違うところは、個別に確認し、タスク間で共通だと仮定しない。
 WeChat Pay
 Alipay
コメント
コメントは即時公開されますが、ポリシー違反時は非表示になる場合があります。