Claude Code Workflows 詳細解析:オーケストレーションをスクリプトに書き込んだ後
これは昨日(2026 年 5 月 28 日)に出たばかりのもので、Opus 4.8 と一緒にリリースされ、現時点ではまだ research preview です。これは昔からある問題を解決できます:1 つの会話ウィンドウでは多すぎる agent を指揮しきれない、という問題です。以下ではソースコードには触れず、それが何を変えたのか、いつ使うと得なのか、いつ単なる token の無駄なのかだけを説明します。
まず座標系の中に戻しておく
workflow の前から、Claude Code にはすでに「複数ステップで作業する」方法が 2 つありました:subagent と skill です。3 つはいずれも複数ステップのタスクを実行できますが、本当の違いは一言で言えます——plan を誰が握っているかです。
| Subagent | Skill | Workflow | |
|---|---|---|---|
| 本質 | Claude が送り出す 1 人の worker | Claude が読み上げる 1 つの説明書 | runtime が実行する 1 本のスクリプト |
| 次の一手を決めるのは誰か | Claude が、ラウンドごとに決める | Claude が、prompt に沿って進む | スクリプト自体 |
| 中間結果はどこに置くか | Claude のコンテキスト | Claude のコンテキスト | スクリプト内の変数 |
| 再現できるもの | worker の定義 | その説明書 | オーケストレーションロジック全体 |
| 規模 | 各ラウンドで数個の委任 | 左と同じ | 1 回につき数十から数百の agent |
| 中断された場合 | ラウンド全体をやり直し | ラウンド全体をやり直し | 同一セッション内で続行可能 |
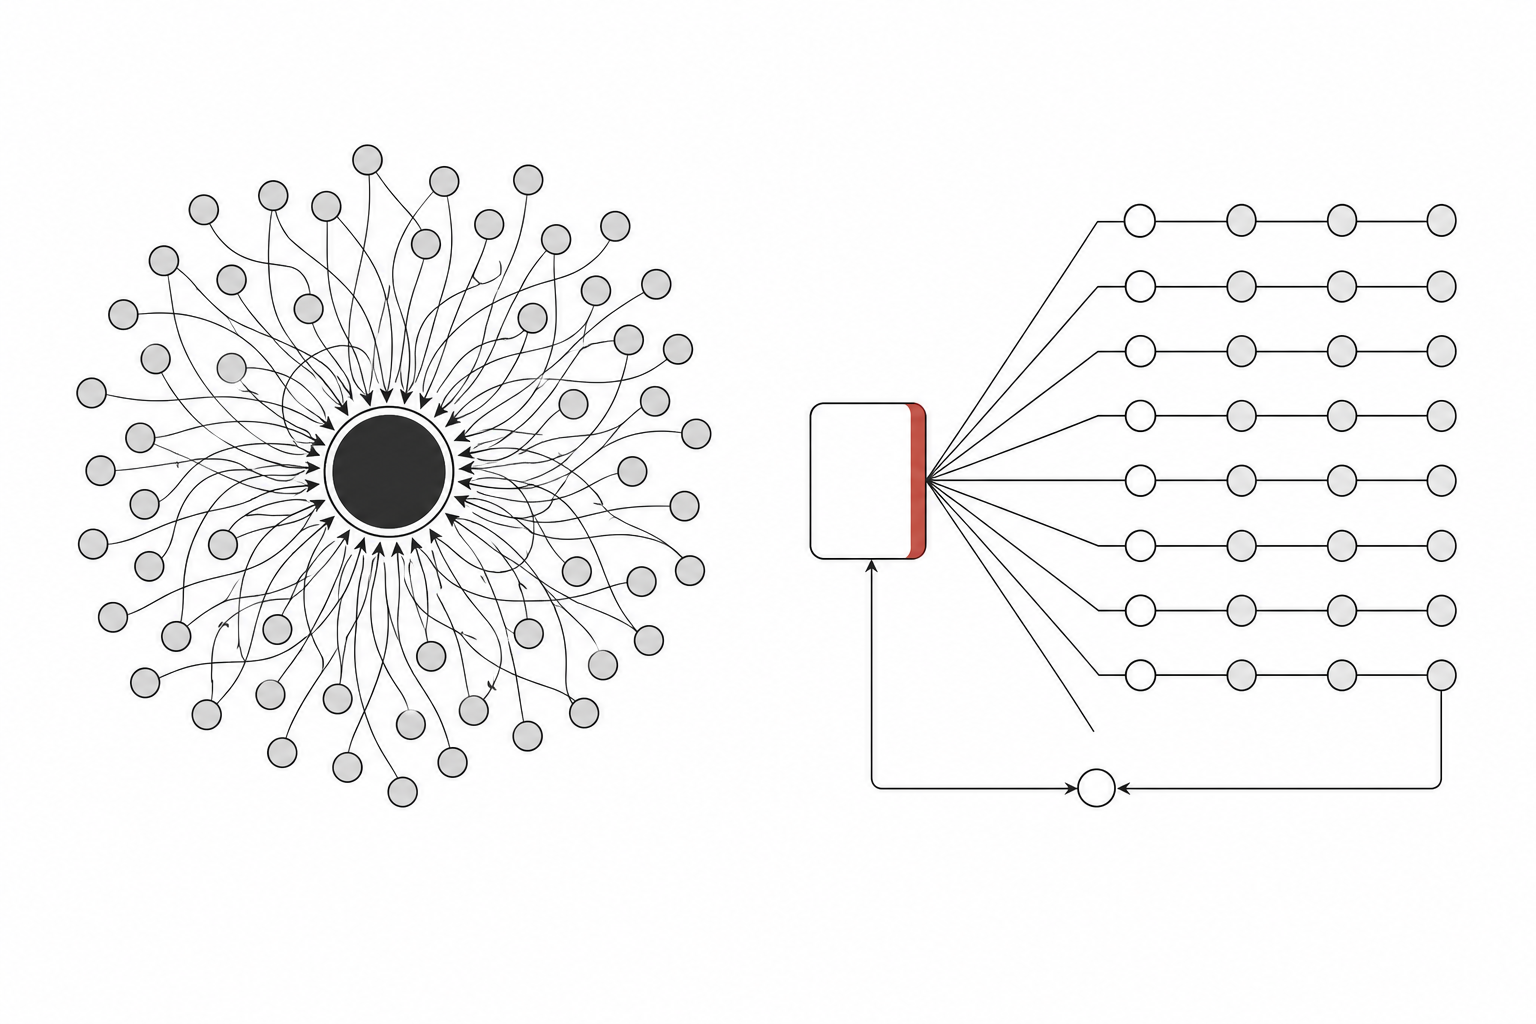
subagent と skill を使うとき、Claude はそのディスパッチャーです:次に何を spawn するかをラウンドごとに決め、各結果はすべてそのコンテキストへ戻ってきます。ウィンドウが長くなると、コンテキストは中間生成物で膨れ上がり、Claude 自身も前に誰を派遣したのか、誰が何を返したのかを覚えきれなくなります。
workflow は、スケジューリングという作業を会話の中からコードへ移します。ループ、分岐、中間結果はすべてスクリプト変数の中に留まり、Claude のコンテキストには最後の答えだけが届きます。これが前 2 者との最も本質的な違いであり、数百の agent まで拡張しても混乱しない理由でもあります。
「plan をコードに書く」ことで何が得られるか
コンテキストがきれいになる以外にも、コードへ移すことで、agent の数を積むだけでは得られないものが 2 つ手に入ります。
1 つ目は再現性です。スクリプトこそがオーケストレーションそのものです。「各ブランチをまずそれぞれ走らせ、最後にまとめて重複排除する」というロジックは、今回走らせても次回走らせても同じコードであり、Claude がその場でもう一度考え直すものではありません。各ブランチの review は 1 件終われば続けて 1 件検証し、遅いものが速いものを足止めしません。
2 つ目は品質モードに入れることで、単により多く走らせるだけではないことです。オーケストレーションがコードなので、互いに独立した複数の agent に、お互いの発見を対抗的にレビューさせることができます——ある結論は多数票を通って初めて有効になる、という形です。また、いくつかの異なる観点からそれぞれ案を作らせ、比較したうえで 1 つを選んで提出することもできます。これは単発実行では得られない信頼度です。
pipeline か parallel か:最初からバリアを足さない
実際にスクリプトを書くとき、最も踏みやすい判断ミスがこれです。実行方法は 2 つあります:
- pipeline(デフォルト):各項目がすべてのステージを独立して通過し、ステージ間にバリアはありません。A 項目はすでに第 3 ステージにいて、B 項目はまだ第 1 ステージにいることができます。壁時計時間はおおよそ最も遅い 1 本のチェーンに等しく、「各ステージの最遅の合計」ではありません。
- parallel(バリア):すべてのタスクが全部終わるまで待ってから次へ進みます。
多段階タスクのデフォルトは pipeline であるべきです。「第 N ステージが本当に第 N-1 ステージのすべての結果をまとめて必要とする」ときだけ、バリアは成立します——たとえば全量重複排除の後に下流の高コストな検証をする場合や、総数がゼロならその区間全体をスキップする場合です。
成立しない理由もよくあります:「先に flatten/filter しないといけない」——それは pipeline のどこかのステージ内でやれば十分です。「2 つのステージは概念上分かれている」——分かれていることは同期が必要なことと同じではありません。5 つの finder が並列に動き、最も遅いものが最も速いものの 3 倍かかるなら、バリア 1 つで速い finder の 3 分の 2 のアイドル時間を無駄にするだけです。迷ったら pipeline を選びます。
いつ使うべきか、いつ使わないべきか
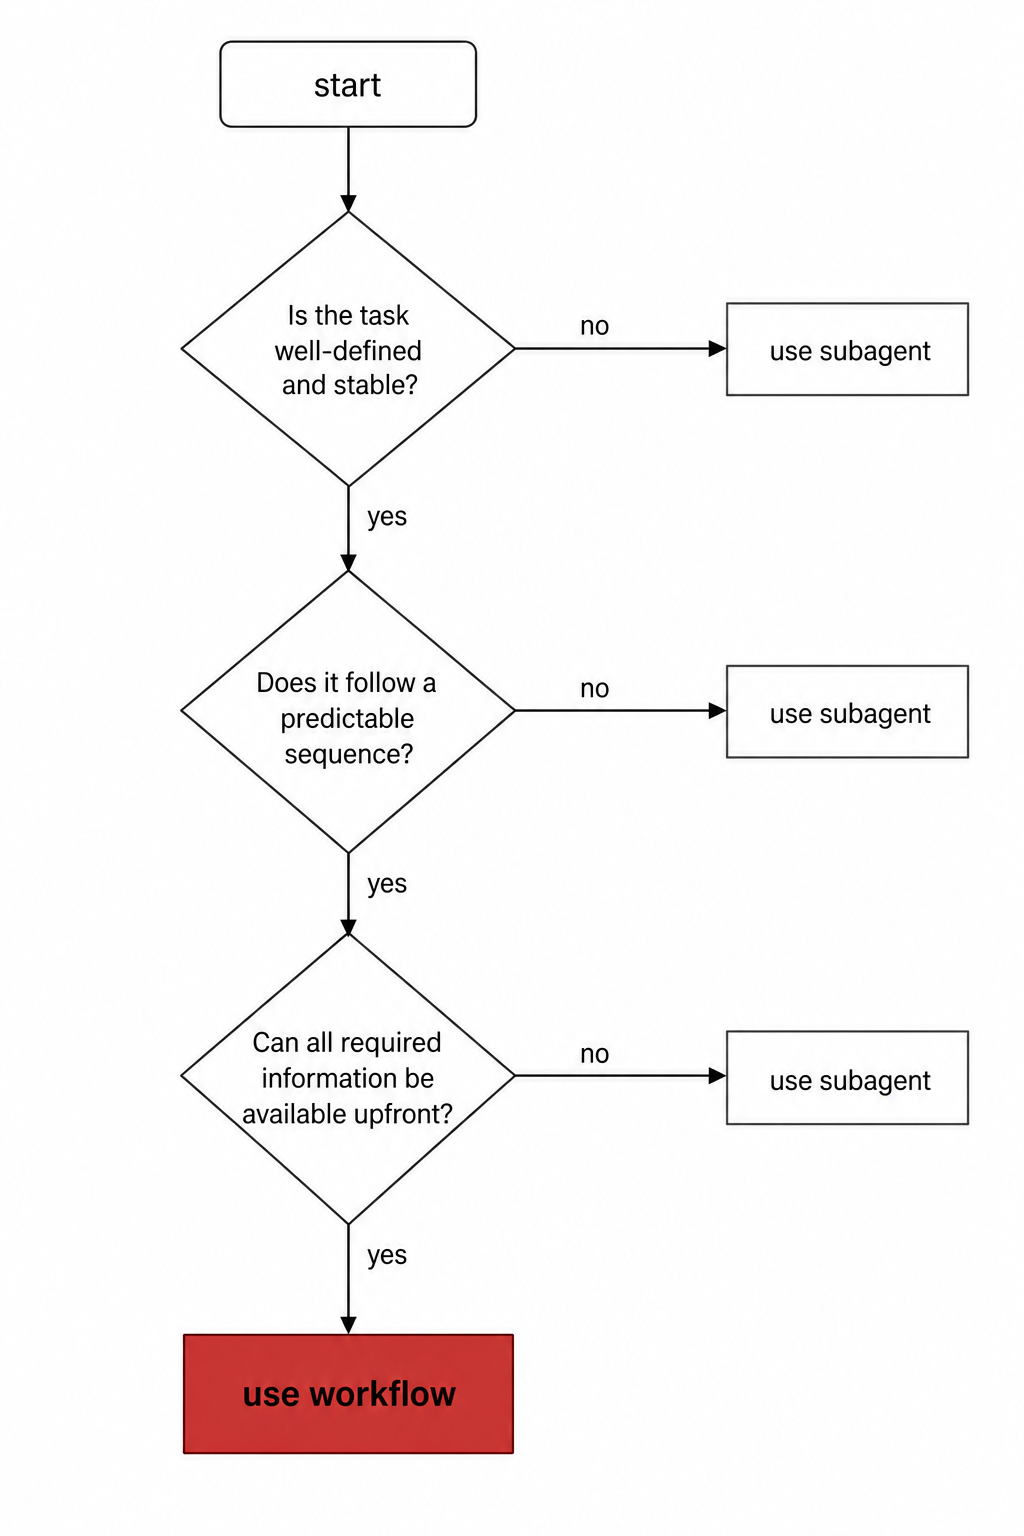
判断基準は実は 1 つだけです:この作業に必要な agent の数を、1 つの会話ウィンドウでまだ調整しきれるか?調整できるなら subagent で十分です。調整できない、またはオーケストレーションを読めて再実行できる 1 本のスクリプトとして沈めたいときにだけ、workflow を使います。
| 適している | 適していない |
|---|---|
| リポジトリ全体を対象にした bug / セキュリティ監査 | 1 つの関数を変更する、明確な bug を修正する |
| 500 ファイルの移行 | 一言聞けば答えられる事実確認 |
| 複数ソースをクロスチェックする必要がある調査 | 途中であなたの判断や段階ごとの承認が必要なプロセス (workflow は実行開始後、途中で入力を受け付けられません) |
| いくつかの独立した観点からそれぞれ案を作る価値がある難しい方案 | リファクタリング / ドキュメント / 改名 / 依存関係更新のようなついで作業 |
直感に反する点があります:workflow は実行開始後、途中であなたに入力を求めることができません。停止できるのは agent の権限ポップアップだけです。したがって「途中までやったら一度見せて、それから決めさせて」というプロセスは、1 つの workflow に詰め込まないでください——各ステージをそれぞれ別の workflow に分け、ステージ間であなたが承認します。
3 種類の起動方法
1. prompt に workflow という語を含める。会話の effort は変えず、この 1 つのタスクだけを workflow として実行します。Claude Code はこの語をハイライトし、それからスクリプトを書いてくれます。誤って起動した場合は alt+w でキャンセルします。
Run a workflow to audit every API endpoint under src/routes/ for missing auth checks2. ultracode モード。/effort ultracode は xhigh 推論 + 自動オーケストレーションを有効にします。有効にすると Claude は各タスクで workflow を起動するかどうかを自分で判断します——1 つのリクエストで 3 つ連続して起動することもあります:1 つはコード理解、1 つは修正、1 つは検証です。代償として、セッション全体の各タスクで token 消費が増え、遅くなります。日常作業に戻るときは忘れずに /effort high で下げてください。
3. 既成 / 保存済みコマンド。/deep-research は組み込みです。自分で満足できる workflow を実行できたら、/workflows で選択して s を押すとコマンドとして保存できます——プロジェクトの .claude/workflows/(リポジトリで共有)またはホームディレクトリの ~/.claude/workflows/(自分だけが使用)に保存し、次回は直接 /<名前> で呼び出します。毎回の review で同じオーケストレーションを走らせるなら、これはかなり便利です。
コストといくつかの厳しい制限
workflow は agent を多数 spawn するため、1 回で消費する token は、会話内で同じことを完了する場合より明らかに多くなります。また通常どおり、あなたのプランの使用量とレート制限にカウントされます。知っておくべき境界は次のとおりです:
| 同時実行 agent は最大 16 個 | CPU コアが少ないマシンではさらに少ない;超過分はキューに入り、1 つ終わると 1 つ補充される |
| 1 回あたり最大 1000 個の agent | 暴走ループへのセーフティネット |
| 途中入力はできない | agent の権限ポップアップだけが一時停止できる;段階ごとに承認したいなら複数の workflow に分ける |
| スクリプト自体はファイルシステム/shell に触れない | 読み書きやコマンド実行は agent が行い、スクリプトは調整だけを担当する |
| 同じセッション内なら resume 可能 | 完了済みの agent はキャッシュ結果を返し、残りの live は再実行される;Claude Code を終了して入り直すと最初からになる |
節約のための 2 つの行動:大規模実行の前に /model で、まだ大きなモデルにぶら下がっていないか確認する;タスクを説明するときに「重くない段階では小さいモデルを使う」と直接言う——各 agent はデフォルトでセッションと同じモデルを使います。スクリプトが特定の段階だけ別ルーティングしない限り。
実用上の一言
workflow は「より強い subagent」ではありません。オーケストレーションという作業を Claude のその場の判断から取り出し、あなたがレビューでき、再実行でき、クロス検証できるコードとして固定化するものです。だから得意領域は非常に明確です:1 つのウィンドウに収まらないほど規模が大きい作業、あるいは結論が重要で、複数の agent に相互検証させる価値がある作業です。日常のコード修正なら、素直に Claude にシングルスレッドでやらせたほうが、むしろ速くて安く済みます。
 WeChat Pay
 Alipay
コメント
コメントは即時公開されますが、ポリシー違反時は非表示になる場合があります。