まず結論から。このシステムは月額5ドルからの Cloudflare Workers プラン上で動作し、5つの AWS リージョンから同時に負荷をかけたところ、読み取りパスは約85万 RPSを継続的に受け止め、ピークは88万、worker エラーはゼロだった。しかも潰れたわけではなく、先に限界に達したのは負荷生成側だった。
荒唐無稽に聞こえるが、マシンを積み増して実現しているわけではない。この記事では、何に支えられているのかを明確にし、同時に2回つまずいた実例も率直に説明する。1回目は直したと思っていたが、2回目でようやく本当の根本原因を掘り当てた。
なぜ自前で KV を作るのか
業務はボール単位の抽選結果発表だ。ボールが1つ出るたびに結果を1回書き込む。このデータの有効期間はわずか1秒であり、同時に大量のユーザーが毎秒この結果をポーリングする。Cloudflare 標準の Workers KV は結果整合性で、書き込みの伝播には秒単位、場合によっては数十秒かかる。「1秒で期限切れになる」データには使えない。そこで Workers + Durable Objects の上に自前で構築した。
ボトルネックを整合性の源泉にする
Durable Object で最も嫌われがちな点は単一スレッドであることだ。各オブジェクトは同時に1つのリクエストしか処理せず、残りはキューに並ぶ。直感的には、それを回避したくなる。
私たちは逆に考えた。単一スレッドであることは、同じ key のすべての読み書きが自然に直列化され、競合がないことを意味する。これはまさに抽選結果データが必要とする整合性だ。そこで設計はこうなった。この単一スレッドオブジェクトを唯一の真実の源として受け入れ、その手前に防御層を重ね、本当にそこへ到達するトラフィックを耐えられる量まで圧縮する。
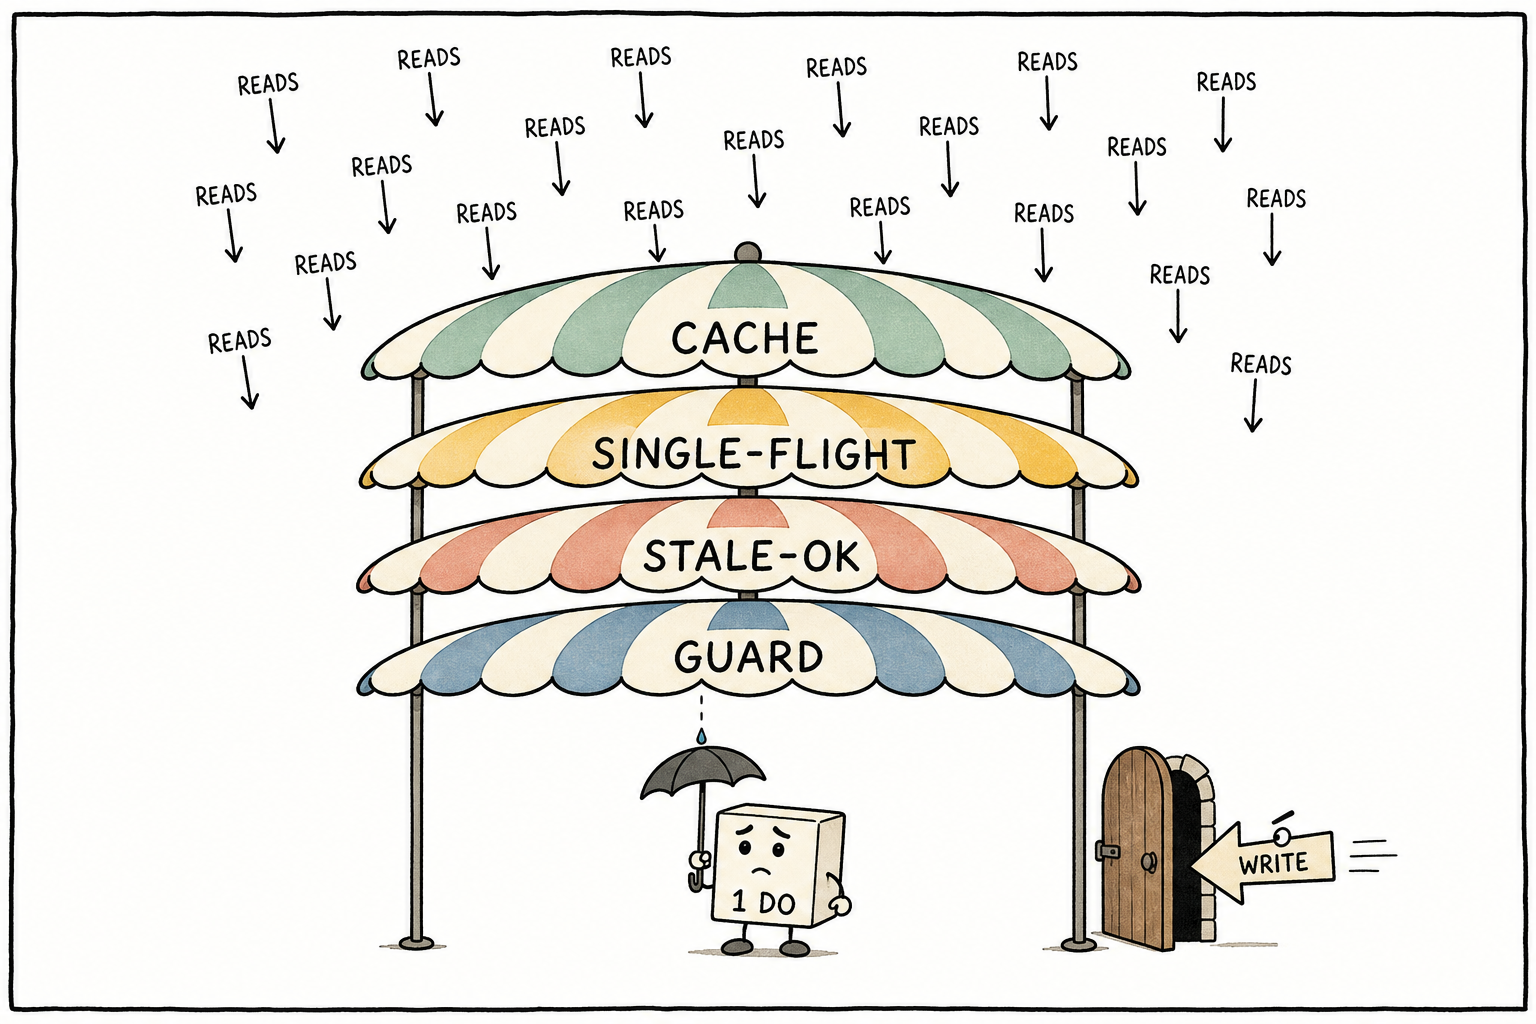
4層の防御がそれぞれトラフィックの一部を吸収する:
- エッジキャッシュ(
caches.default):Cloudflare の各データセンターごとに1つの共有キャッシュを持ち、多くの読み取りはユーザーに最も近いノードで返される。 - single-flight:同じ isolate 内で、同じ key に対する並行オリジン取得を
Map<key, Promise>で1回にまとめる。 - Stale-While-Revalidate:キャッシュが期限切れになっても先に古い値をユーザーへ返し、バックグラウンドでゆっくり更新する。ユーザーは待たない。
- null プレースホルダー + 空レスポンスへのフォールバック:存在しない key には短命のプレースホルダーを書き、貫通を防ぐ。本当に耐えられない時でも読み取りパスはエラーコードを返さず、すべて 200 の空レスポンスに降格ヘッダーを付ける。フロントエンドが 200 以外をすべてユーザーにポップアップ表示してしまうため、この対策はユーザーからのフィードバックに教えられたものだ。
目立たないが重要な決定がもう2つある。1つ目は二重 TTL だ。論理的な鮮度(抽選 key は1秒)は「この値を古いと見なすか」を管理し、ストレージ TTL(900秒)は「キャッシュエントリ自体をどれだけ残すか」を管理する。両者を分けることで、古い値を継続的なセーフティネットにできる。2つ目はホットとコールドの分離だ。ホットスポット key はハッシュに基づいて専用シャードへ流し、通常 key と隔離する。ホットスポットの嵐が他へ飛び火しない。
最初の障害:書き込みが読み取りに踏み潰された
ある夜の抽選で、書き込みパスがまとめて壊れた。SET 成功率は 4% まで落ち、最も遅い書き込みは 17.3 秒待った末に失敗した。振り返ると、当時はキャッシュのオリジン取得が統合されておらず、抽選の瞬間に数万件の読み取りリクエストがそれぞれ同じ単一スレッド DO を叩きに行き、キューを埋め尽くしていた。ボール単位の書き込みはキューの末尾に並ばされ、順番が回ってこなかった。
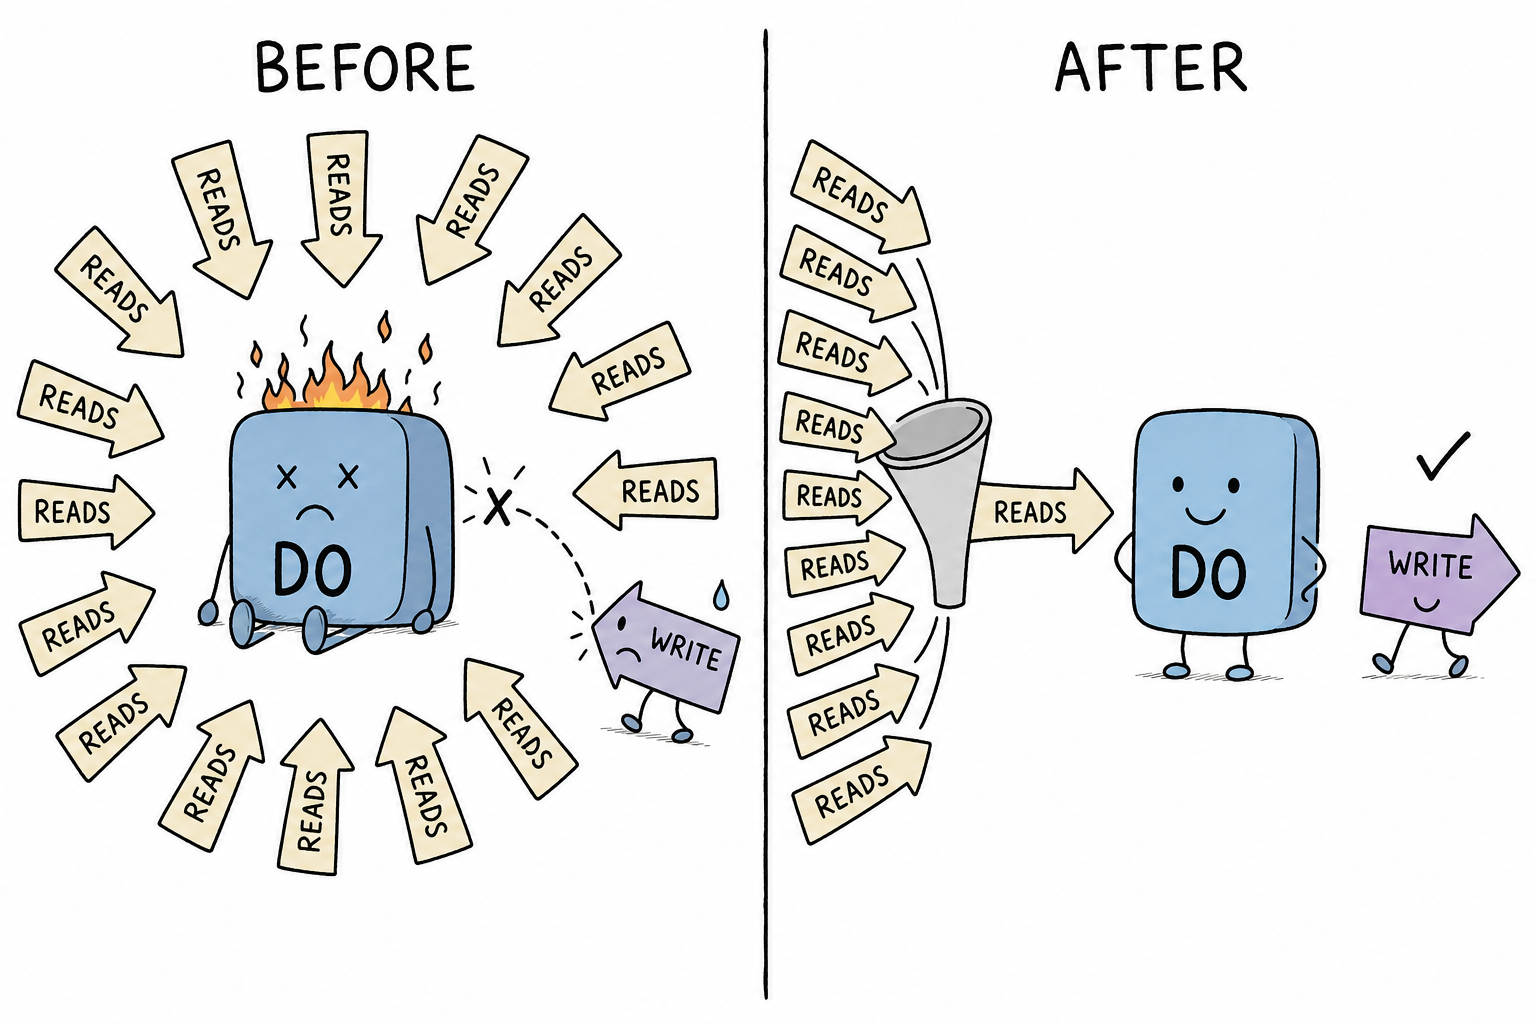
修正は single-flight を補い、抽選キーの論理 TTL を 1 秒に縮めることだった。同じ負荷で再テストすると:
| 指標(同負荷、同 key、各 5 分) | 修正前 | 修正後 |
|---|---|---|
| SET 成功率 | 4% | 100% |
| 書き込み後 5 秒以内に新値を読めた割合 | 6% | 99.7% |
| 最も遅い書き込み | 約 17 秒 | サブ秒 |
本番投入後の最初の実際の抽選では、トラフィックは事故当夜よりさらに 58% 大きかったが、DO エラーは 7 からゼロになった。その時点で、私たちはこの件は片付いたと思っていた。
5 ドルの土台、86 万 RPS の負荷試験
システムは Workers の有料プラン上で動いており、開始は 5 ドル、従量課金で、常駐マシンは 1 台もない。安い理由は節約ではなく、読み取りの RPS とコストが切り離されていることだ。読み取りはエッジキャッシュで食い止められ、呼び出し課金の DO まで実際に貫通する量は無視できるほど小さい。負荷試験では読み取りスループットを毎秒 85 万まで引き上げたが、DO 側で増えた呼び出しは毎分 1〜2 万回にすぎなかった。
つまり 86 万はこのアーキテクチャの上限ではなく、あの夜の私たちの発圧能力の上限でしかない。送った分だけエッジが捌き、曲線はずっと伸び続けていた。
2 度目の事故:直ったと思っていた
single-flight の投入後 1 週間、毎回の抽選でまだ 1〜2 枚の書き込み失敗カードが出ており、所要時間は正確に 16050 ミリ秒で止まっていた。この数字はあまりに整っている。私たちは DO 呼び出しに 8 秒のタイムアウトと 1 回のリトライを入れていた。8000 + 50 + 8000、2 回ともタイムアウト。つまりその DO は丸々 16 秒間、誰にも応答していなかった。
順に 3 つの手を試したが、どれも根絶には至らなかった:
- 読み書きの両方にタイムアウトとリトライを追加。失敗は毎回 5 枚から 2 枚に減り、30 秒の固まりは最大 16 秒に収まったが、リトライ先は結局、詰まっている同じ DO だった。
- 定期プリウォーム。ホットな DO はアイドルが 2 秒ほど続くとプラットフォームに追い出されることが分かったため、cron を追加し、抽選ウィンドウ内では 2.5 秒ごとにすべてのホット DO に ping した。プリウォーム自体は確かに効いていた(監視でベースラインの上昇が見えた)が、失敗は相変わらずだった。
- テスト環境の DO を 1 分間に 10 回再起動させ、接続断を再現しようとした。600 並列でレイテンシを 23 秒まで押し込んでも、リクエストはすべて成功し、単機では再現できなかった。
2 つの失敗現場の分単位データを並べてみて、ようやく 2 種類の発火条件と同じ病根が見えた:
| 現場 | 当時の負荷 | DO エラー | 説明 |
|---|---|---|---|
| 夜間の抽選 | worker 42 万/分、DO 呼び出し 12.7 万/分 | 失敗した 2 分間はそれぞれ 2725、4012 | 読み取りの洪水が単一 DO のキューを埋め、書き込みが列の末尾でタイムアウト |
| 日中の抽選 | 全サイト約 60 RPS、ほぼ空載 | その 1 分間で 183 | プラットフォームがこの DO を移動/再起動し、ちょうど書き込みにぶつかった |
空載でも爆発するということは、2 つ目の発火はトラフィックと無関係で、単にプラットフォームが DO の居場所を移し、飛行中のリクエストが切られたということだ。一方、高負荷側では、洪水の主力はキャッシュ miss でもなかった。キャッシュ項目は 900 秒保存されるため、本当の miss はほぼ起きない。原因は SWR のバックグラウンド更新だった。値は 1 秒ごとに stale になり、各データセンターの各 isolate が毎秒それぞれバックグラウンドでオリジンへ戻る。single-flight がまとめられるのは単一 isolate 内の同時実行だけで、数百の isolate が毎秒一斉射撃するのは防げない。
病根はひとつだけだった:1 つのホット key のすべての読み取りと書き込みが、同じ単一スレッド DO の同じキューに並んでいる。読み取りが一定以上多くなれば、書き込みは死ぬしかない。
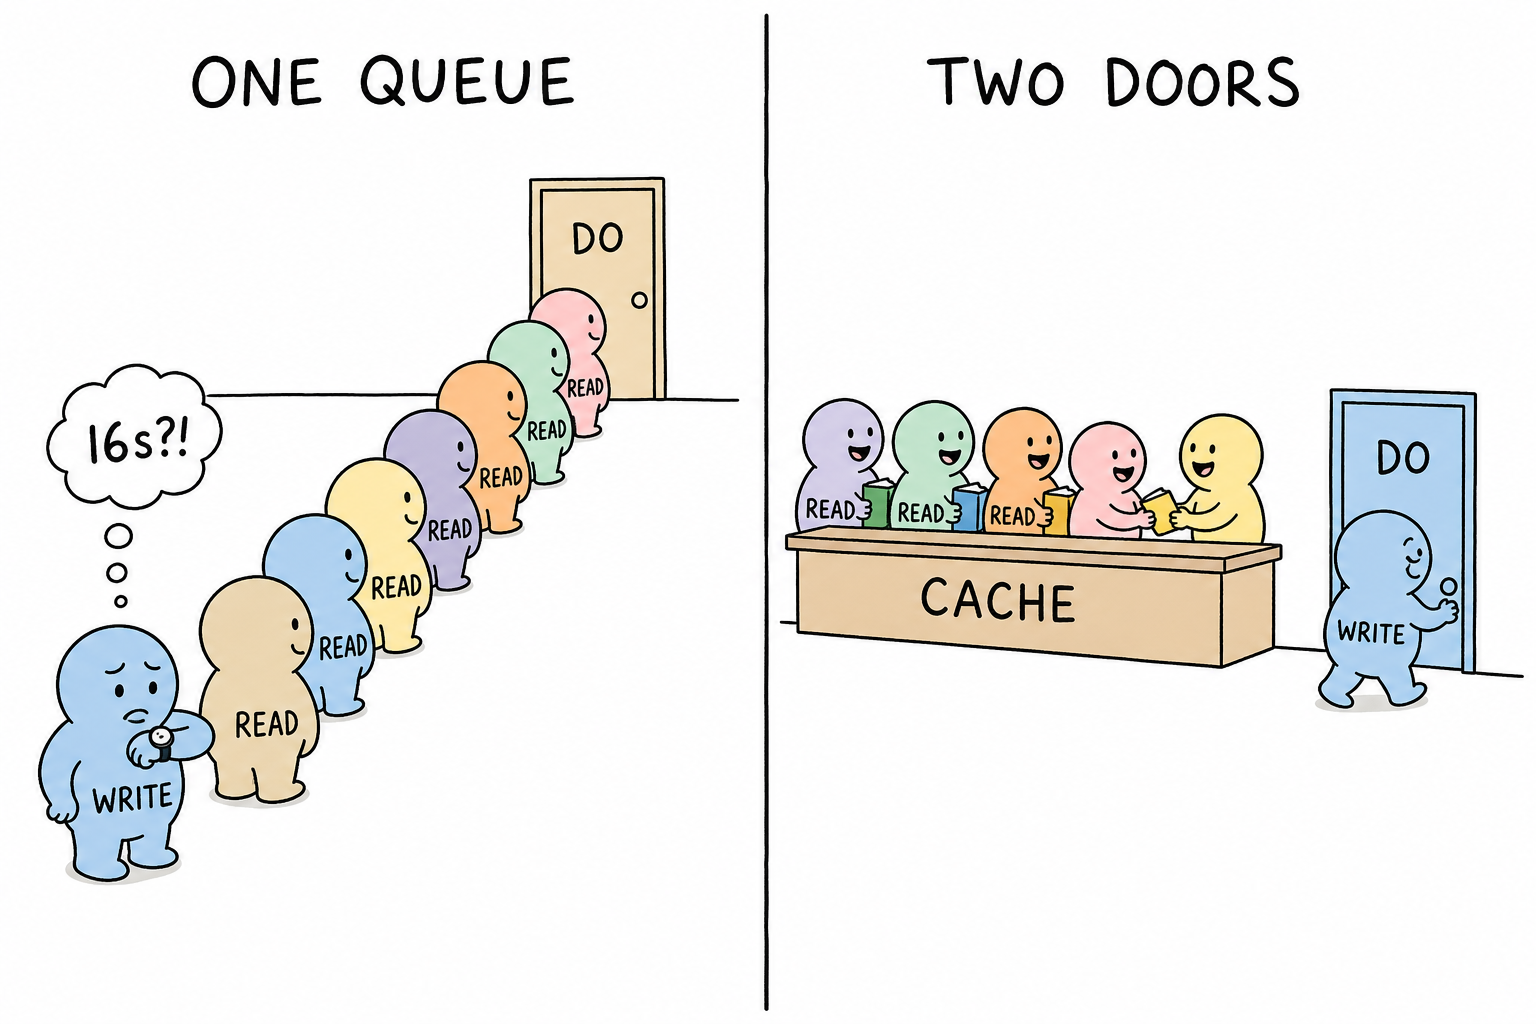
解法:読み書きを別の門に分け、「強整合性」を言い直す
私たちは案を GPT に渡し、外部レビュー役として批判してもらった。它は 2 つの候補を却下した。TTL を緩めるのは止血にすぎず、読み取りはなお書き込み DO のキューに入る。K 個の同期レプリカを作るのはさらに悪く、書き込みは K 個の ACK を待つ必要があり、テールレイテンシも失敗率も上がり、最後には自分たちで quorum を再発明することになる。它が示した主線は私たちの判断と一致していた。原文はこうだ:SET にさらにタイムアウトとリトライを足すな。SET がユーザー読み取りと同じ列に並ばなくて済むようにしろ。
実装は 3 段階だった:
- TTL を 1 秒から 2 秒に伸ばす。更新嵐の頻度は 1/TTL に等しいため、1 行の変更でそのまま半減した。
- ユーザー読み取りは、ほぼ同期的に DO を叩かなくする。キャッシュに値があれば(たとえ stale でも)直接返す。バックグラウンド更新にはスロットリングを入れる。本当に完全に空の miss(冷えたデータセンターの初回読み取り、まれ)だけは 1.2 秒の制限付きレースにする。DO が健全なら真のデータを直接返し、止まっていれば空レスポンスに退化させ、バックグラウンドで回填を続ける。ここで私たちは一度つまずいた。最初は 503 を返してフロントエンドにエラーダイアログを出させてしまい、ユーザーに教えられた:縮退は呼び出し側がすでに処理できる意味論の中へ落とすべきで、新しいエラーコードを発明するべきではない。それ以来、DO が見るのは「レート制限されたバックグラウンド更新と書き込み」だけになり、書き込みはキューを独占する。
- 書き込みリトライ間隔を 50 ミリ秒から 1.5 秒へ変更する。50 ミリ秒後のリトライは、基本的に移行中の同じ DO にまたぶつかる。1.5 秒あれば、DO が落ち着くには十分だった。
代償ははっきり言わなければならない。ユーザー読み取りの鮮度は「名目上の 1 秒」から「上限のある 1 から 2 秒」になった。以前の caches.default に SWR を足した仕組みも、そもそも厳密な read-after-write は実現できていなかった。ただ誰もそれを明言していなかっただけだ。今は約束を二つの正直な言葉に書き換えた:書き込み側は強整合で、各書き込みは成功するか明確に失敗するかのどちらか;読み取り側は 1 から 2 秒の有界な陳腐化を許す。ビジネス側がこれを受け入れられて初めて、このアーキテクチャは閉じた輪になる。
リリース初夜:データは半減、根はまだ息をしている
読み書き分離をリリースした夜の抽選を、前夜の同じ時間帯と比べると:
| 指標(抽選ウィンドウ 40 分) | 改修前夜 | リリース当夜 |
|---|---|---|
| DO エラー合計 | 6,738 | 325(-95%) |
| DO 呼び出しピーク | 12.7 万/分 | 6.1 万/分(-52%) |
| 書き込み失敗 | 2 件,16.0s | 1 件,17.5s |
| 遅い操作 | 4 件 | 1 件 |
方向はすべて正しく、規模も半分に削れたが、私たちが自分たちに課した受け入れラインは「書き込み失敗ゼロ、DO 呼び出しを 1 桁落とす」だったので、どちらにも届いていなかった。調べると、残っていた穴は二つだった。
一つ目:スロットリングの粒度が間違っていた。「各 isolate ごとに毎秒最大 1 回だけ更新」は一見かなり厳しいが、抽選時の 6000 RPS は Cloudflare に何百、何千もの isolate を起動させる。その多くは生まれたばかりで、スロットリング表は空、最初の一拍で更新を一度通してしまう。実際に DO へ当たる更新量は isolate 数 × キー数になり、isolate が増えるとスロットリングは有名無実になる。修正方法はロックを isolate 級からデータセンター級へ引き上げることだった:caches.default(そもそもデータセンターごとに一つある)に 1 秒のロックを置き、同じデータセンターの同じ key では、ロックを取れた isolate だけが本当にオリジンへ戻る。更新量は「isolate 数 × キー数」から「データセンター数 × キー数」へ圧縮された。
二つ目:三本の古い接口が防御全体を迂回していた。このシステムは何度かの世代を経て進化してきたため、「DO へ直結し、キャッシュを通らない」バイパス読み取り接口がいくつか残っていた。メイン経路をどれだけ直しても、消費側がバイパス経由でホットキーをポーリングしていれば、読み取りはやはり書き込み DO のキューへ押し込まれる。修正方法は、バイパスもホットキーについてはキャッシュ優先にすることだった:値があれば(たとえ 2 秒以内の古い値でも)直接返し、本当にない場合だけ元の同期回源を通す。レスポンス構造は一字も変えないので、既存の呼び出し側を壊すことはない。
ついでに書き込みリトライを二回から三回に増やし、バックオフを 1.5 秒、3 秒と増やした。移行中の DO により長い着地時間を与えるためで、最悪でも 28.5 秒なのでプラットフォームの 30 秒の壁には収まる。
真犯人逮捕:書き込みを詰まらせていたのは流量ではなく、ディスクだった
二期リリース後、読み取り側は完全に静かになった:抽選の最高峰でも、全システムから DO へ当たるのは毎分三千回だけで、改修前の四十分の一だった。それでも毎晩一、二件の書き込みがリトライ予算を使い切って失敗した。誰の仕業か? 私たちは書き込み失敗に「ドライブレコーダー」を取り付けた:失敗した瞬間に、同じ DO へ自動で一度 ping を送り、その状態を撮ってアラートカードに添付する。
翌日には撮れた。30 秒の失敗が二件、ping はすべてタイムアウトし、エラーメッセージにはこう書かれていた:storage operation exceeded timeout。
この一行の重みは説明が必要だ。ping はディスクに触らない。ただ「生きているか」と一言聞くだけで、その一言にさえ誰も応じなかった。理由は Durable Object の内部ルールにある:ディスク操作が一つでも完了していない限り、それは門を閉ざし、どんな新しいリクエストも受け付けない(公式には input gate と呼ばれ、データ整合性を保証するためのものだ)。だから真相はこうだ:DO はちゃんと生きていた。ただ、一回の詰まったディスク操作によって門の内側で塞がれていた。抽選ピークのその瞬間、DO がいるデータセンターのストレージ層は 20 から 60 秒固まることがある。私たちの流量はとっくに容疑が晴れていた。今回は DO 自身の容疑も晴れた。残ったのは、その足元にあるディスクだけだった。
それから、今回の調査で最も価値のある気づきがあった。このシステムの一貫性は、最初から最後まで「店員が一人しかいない」ことに依存している:すべての書き込みのキュー処理が同じ単一スレッドを通るので、順序は自然に乱れない。石板に刻むかどうかは、帳簿の権威性には最初から影響しない。ところが私たちの書き込み確認は、ずっと「その一秒にハードディスクが健康かどうか」に縛られていた。これこそ切り離すべき結合だった。
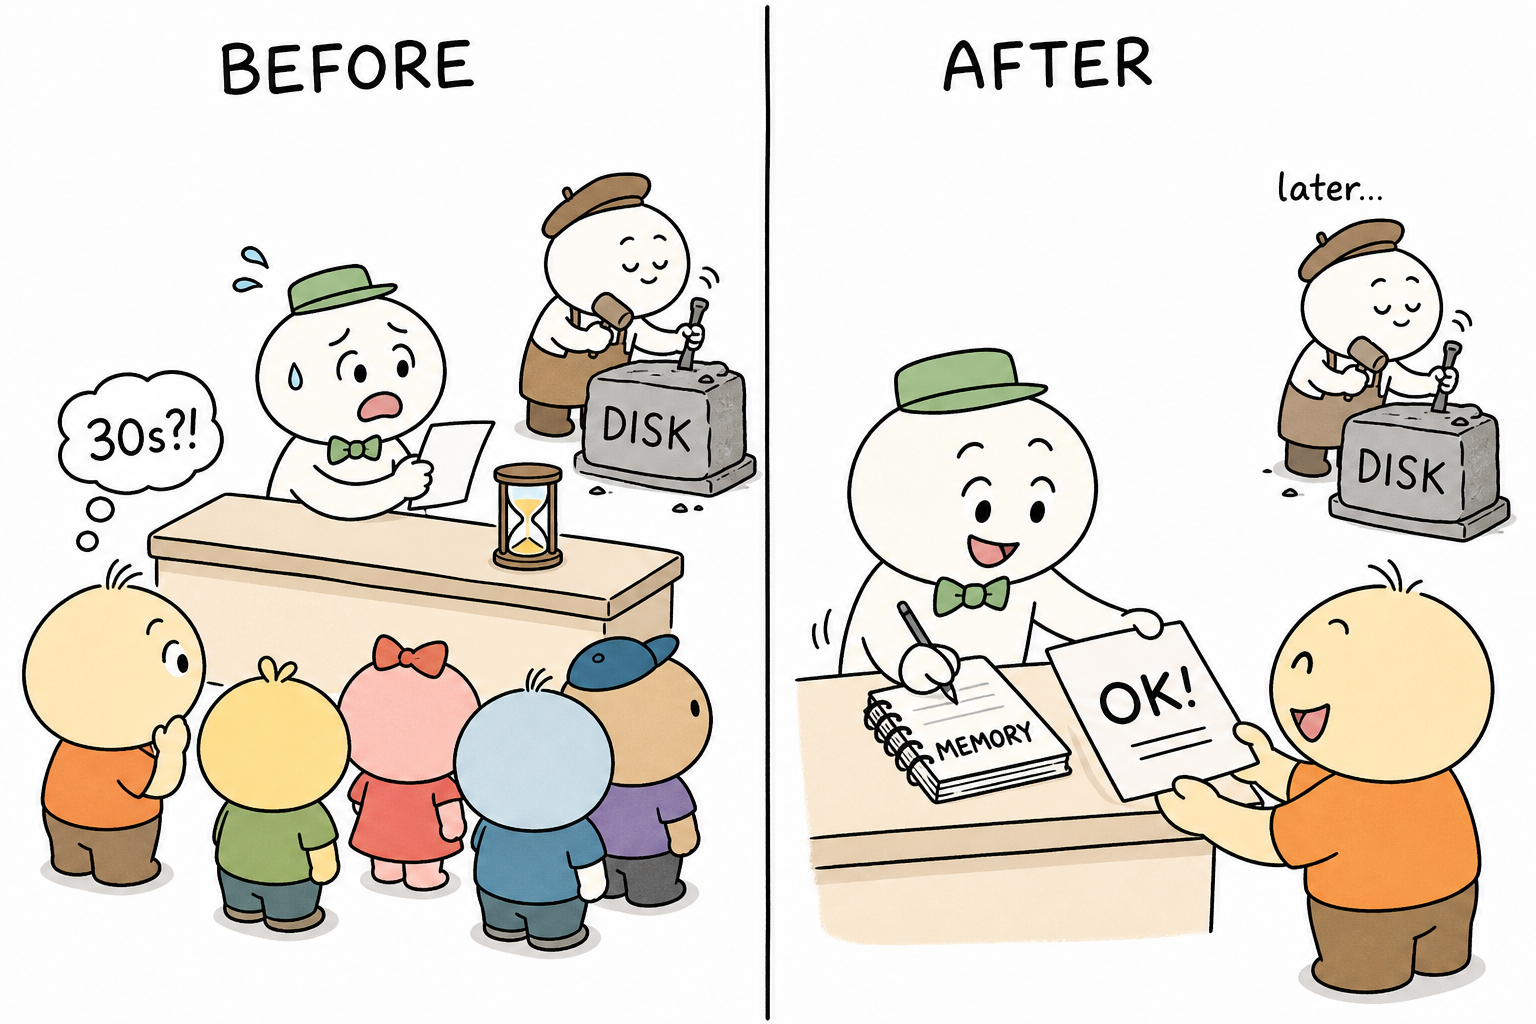
改造を平たく言えば三つだけだ:
- 店員の手元に帳簿を置く。書き込みリクエストが来たら、まず DO 自身のメモリに記し、すぐ「成功」を返す。帳簿こそが権威だ。店員は一人しかおらず、記帳順序が乱れることはないからだ。
- 石工はゆっくり刻む。ディスクへの永続化はバックグラウンドへ回す(Cloudflare がネイティブにサポート、
allowUnconfirmed)。ハードディスクが 60 秒固まっても前段の応答には影響せず、回復すれば自然に刻まれる。 - 二つの保険ルールを立てる。遅れて来た古い帳簿が新しい帳簿を上書きしてはいけない(各書き込みにタイムスタンプのガードを付け、遅延した補助書き込みが新しい一球を古い一球へ戻すのを防ぐ);万一 DO 全体が連絡不能になっても、外側にガード付きのバックグラウンド補助書き込みがあり、失敗後 4 秒、12 秒、24 秒にそれぞれ追加で投げる。
この経路を通るのは抽選のホットキーだけだ。history のように長く残す必要があるデータは、従来どおり石板に刻み終わってから応答し、一文字も変えていない。データセンターのストレージがピーク時に固まること自体はプラットフォームの病気なので、チケットは出す。だが私たちの書き込みは、もうそれに付き合って一緒に病まない。
正直な振り返り:直したものと、まだ直していないもの
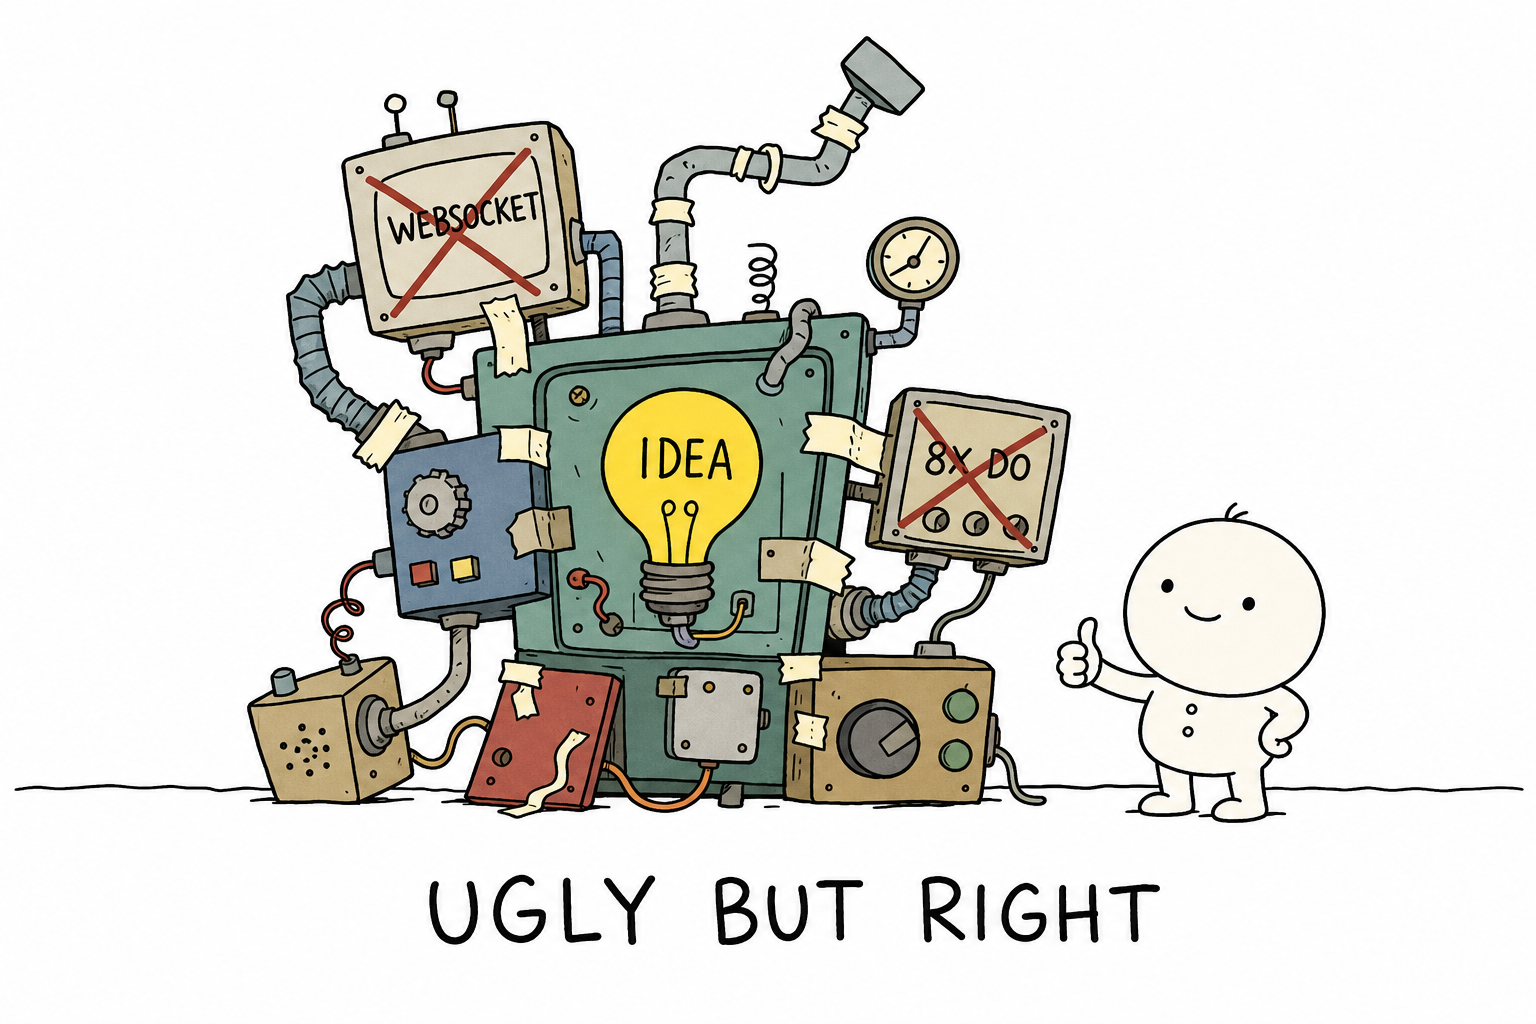
修正できたもの:読み取り経路の single-flight;読み書きのタイムアウトにリトライ追加;4xx と 5xx のアラート分類(以前はクライアントが key を 1 つ打ち間違えただけでも赤いアラートが鳴っていた);ホットスポット DO の定時プレウォーム。
まだ収束していないもの:もっと前の版では 8 個の中心 DO に WebSocket 長接続を足して 2000 同時接続を支えていて、複雑度が高く、今もまだ消し切れていない尻尾が残っている;key に open、current が含まれるかどうかでホットスポットを識別している。粗いが、ずっと間違ってはいない;データセンターのストレージがピーク時に固まる件のチケットを、まだプラットフォームに 1 枚出しそびれている。
振り返ると、このシステムで正しかった点はどのコンポーネントにもなく、いくつかの判断にあった:単一スレッドのオブジェクトは遅く、プラットフォームに気軽に移動されもするが、それは直列であり、直列こそ一貫性なので、それに逆らうのではなく、それに沿って設計する;読み取りが数十倍に増えたとき、コストをほぼ動かさない方法は読み取りをエッジで止めること;監視に重いログを開く必要はなく、業務イベントを永続カードとして流し、プラットフォーム標準の分単位メトリクスを足せばいい。2 回の事故はいずれもこの 2 つで突き止めた。
最初の事故では、直した途端に勝利宣言をした。2 回目で初めて、根がまだ残っていると気づいた。第 1 期でデータを半分に削り、第 2 期で読み取り側の圧力を通常時の 40 分の 1 まで落としたが、それでも毎晩まだ 30 秒の書き込み失敗が 1、2 件残った。ドライブレコーダーがハードディスクを撮るまで、ようやく網を締められなかった。
そしてメモリ帳簿を上线した後の最初の抽選:その夜のトラフィックはこの 6 晩で 2 番目に高く、書き込み失敗 0、遅い操作 0、DO エラーは 3 桁から 1 へ落ち、最も遅い書き込みは 1.68 秒で、しかも同期でディスク永続化する history キーだった。抽選ホットスポット key はすべて 1 秒未満。あの夜、ハードディスクは詰まったのか?分からないし、もう知る必要もない。これこそが分離の意味だ。
ゼロは十分に貯まった。2 晩目、トラフィックはなおピークに近い毎分 47 万、書き込み失敗 0、遅い操作 0、今回は DO エラーも worker エラーも 0。すべての指標が初めて、ひとつ残らずゼロに落ちた。
書き込みが崩壊したあの夜から数えて二十数日、3 回メスを入れた:まず読み取りを合流させ、次に読み書きを分け、最後に書き込み確認をハードディスクの手から解き放った。どの一刀の前にも、私たちは前の一刀でもう十分だと思っていた;どの一刀の理由も、その夜の本番データが示したものだった。今は、2 晩連続でクリーン。この章は、書き終わった。
 WeChat Pay
 Alipay
コメント
コメントは即時公開されますが、ポリシー違反時は非表示になる場合があります。